【项目实战】深度学习:二手车价格预测(含深度学习考试参考资料)
前言
为了更好地理解深度学习,本章我们将以天池大赛的赛事为例实现深度学习的项目实战,同时结合软件的研发流程,梳理形成完整资料,包括:需求设计、概要设计、测试方案、测试报告、用户手册。
文章索引
- 项目目标:简要阐述本次实战的项目目标以及数据集情况
- 项目实战:按照以下四部分介绍项目的实现过程以及代码实现
-
- 数据分析
-
- 数据预处理
-
- 模型训练
-
- 模型推理
-
- 项目资料:为了便于深度学习中级认证考试,梳理相关资料以供参考
-
- 需求设计
-
- 概要设计
-
- 测试方案
-
- 测试报告
-
- 用户手册
-
项目资料仅供参考,请勿直接复制使用。
项目目标
通过深度学习技术,构建一个基于深度学习的二手车价格预测模型,能够根据车辆的各项特征(如品牌、型号、年份、里程等)准确预测其市场价格。
数据集简介
下载地址
https://tianchi.aliyun.com/dataset/175540
内容简介
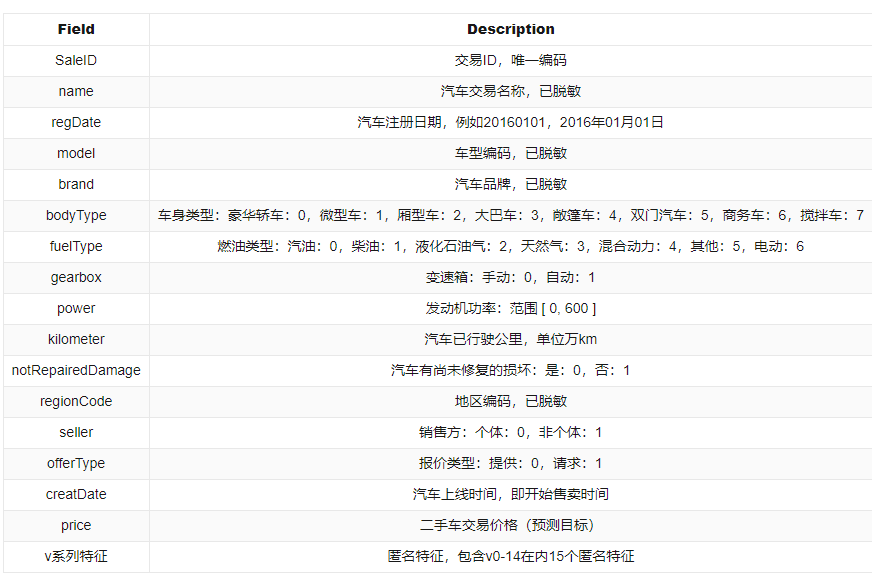
这是阿里天池上的一个数据集,该数据集为二手车交易价格数据集,数据来自某交易平台的二手车交易记录,总数据量超过40w,包含31列变量信息,其中15列为匿名变量。
数据情况
| 数据名称 | 上传日期 | 大小 |
|---|---|---|
| used_car_testB_20200421.csv | 2024-04-16 | 17.06MB |
| used_car_train_20200313.csv | 2024-04-16 | 51.77MB |
数据字段
项目实战
1. 数据分析
1.1 数据分析背景
数据集一般情况下会存在多种问题,以二手车数据为例:
- 数据缺失,例如:二手车某个字段的内容为空...
- 数据异常,例如:二手车价格超过1亿...
- 数据格式问题,例如:二手车价格字段为字符串类型,需要转换为数值类型...
因此,在数据分析有一个专业领域叫EDA(Exploratory Data Analysis),即探索性数据分析。
1.2 探索性数据分析
探索性数据分析是有一套方法论的,由于篇幅原因,本篇文章暂不展开,详情请见CSDN:超全总结!探索性数据分析 (EDA)方法汇总!。
通过了解探索性数据分析,其大致步骤为:
- 检查数据
- 是否有缺失值?
- 是否有异常值?
- 是否有重复值?
- 样本是否均衡?
- ....
- 数据可视化
- 连续量:
- 图表:直方图、盒图、密度图、箱线图等...
- 统计量:均值、中位数、众数、最大值、最小值等...
- 离散量:
- 图表:柱状图、饼图、条形图等...
- 统计量:各个变量的频数、占比等...
- 连续量:
- 考察变量之间的关系
- 连续量与连续量的关系
- 离散量与离散量的关系
- 离散量与连续量的关系 ...
由上可见,数据分析是一门比较专业的学科,是需要专业的理论和方法论来支撑的。
现在有一个开源工具,可以方便我们进行数据的自动化分析:ydata-profiling。
1.3 ydata-profiling
简介
ydata-profiling 是一个数据分析包,只需要几行代码,就可以自动化生成数据集的详细报告,报告包含统计信息和数据摘要。
安装方法
pip install ydata-profiling
pip install ipywidgets
使用方法
import pandas
from ydata_profiling import ProfileReport

# 以下file_train_path是一个文件路径,限于篇幅原因,路径的获取以及赋值在此处省略
df = pandas.read_csv(file_train_path, sep=' ')

# 生成报告
profile = ProfileReport(df, title='Pandas Profiling Report', html={'style':{'full_width':True}})
# 报告输出到jupyter notebook
profile.to_notebook_iframe()
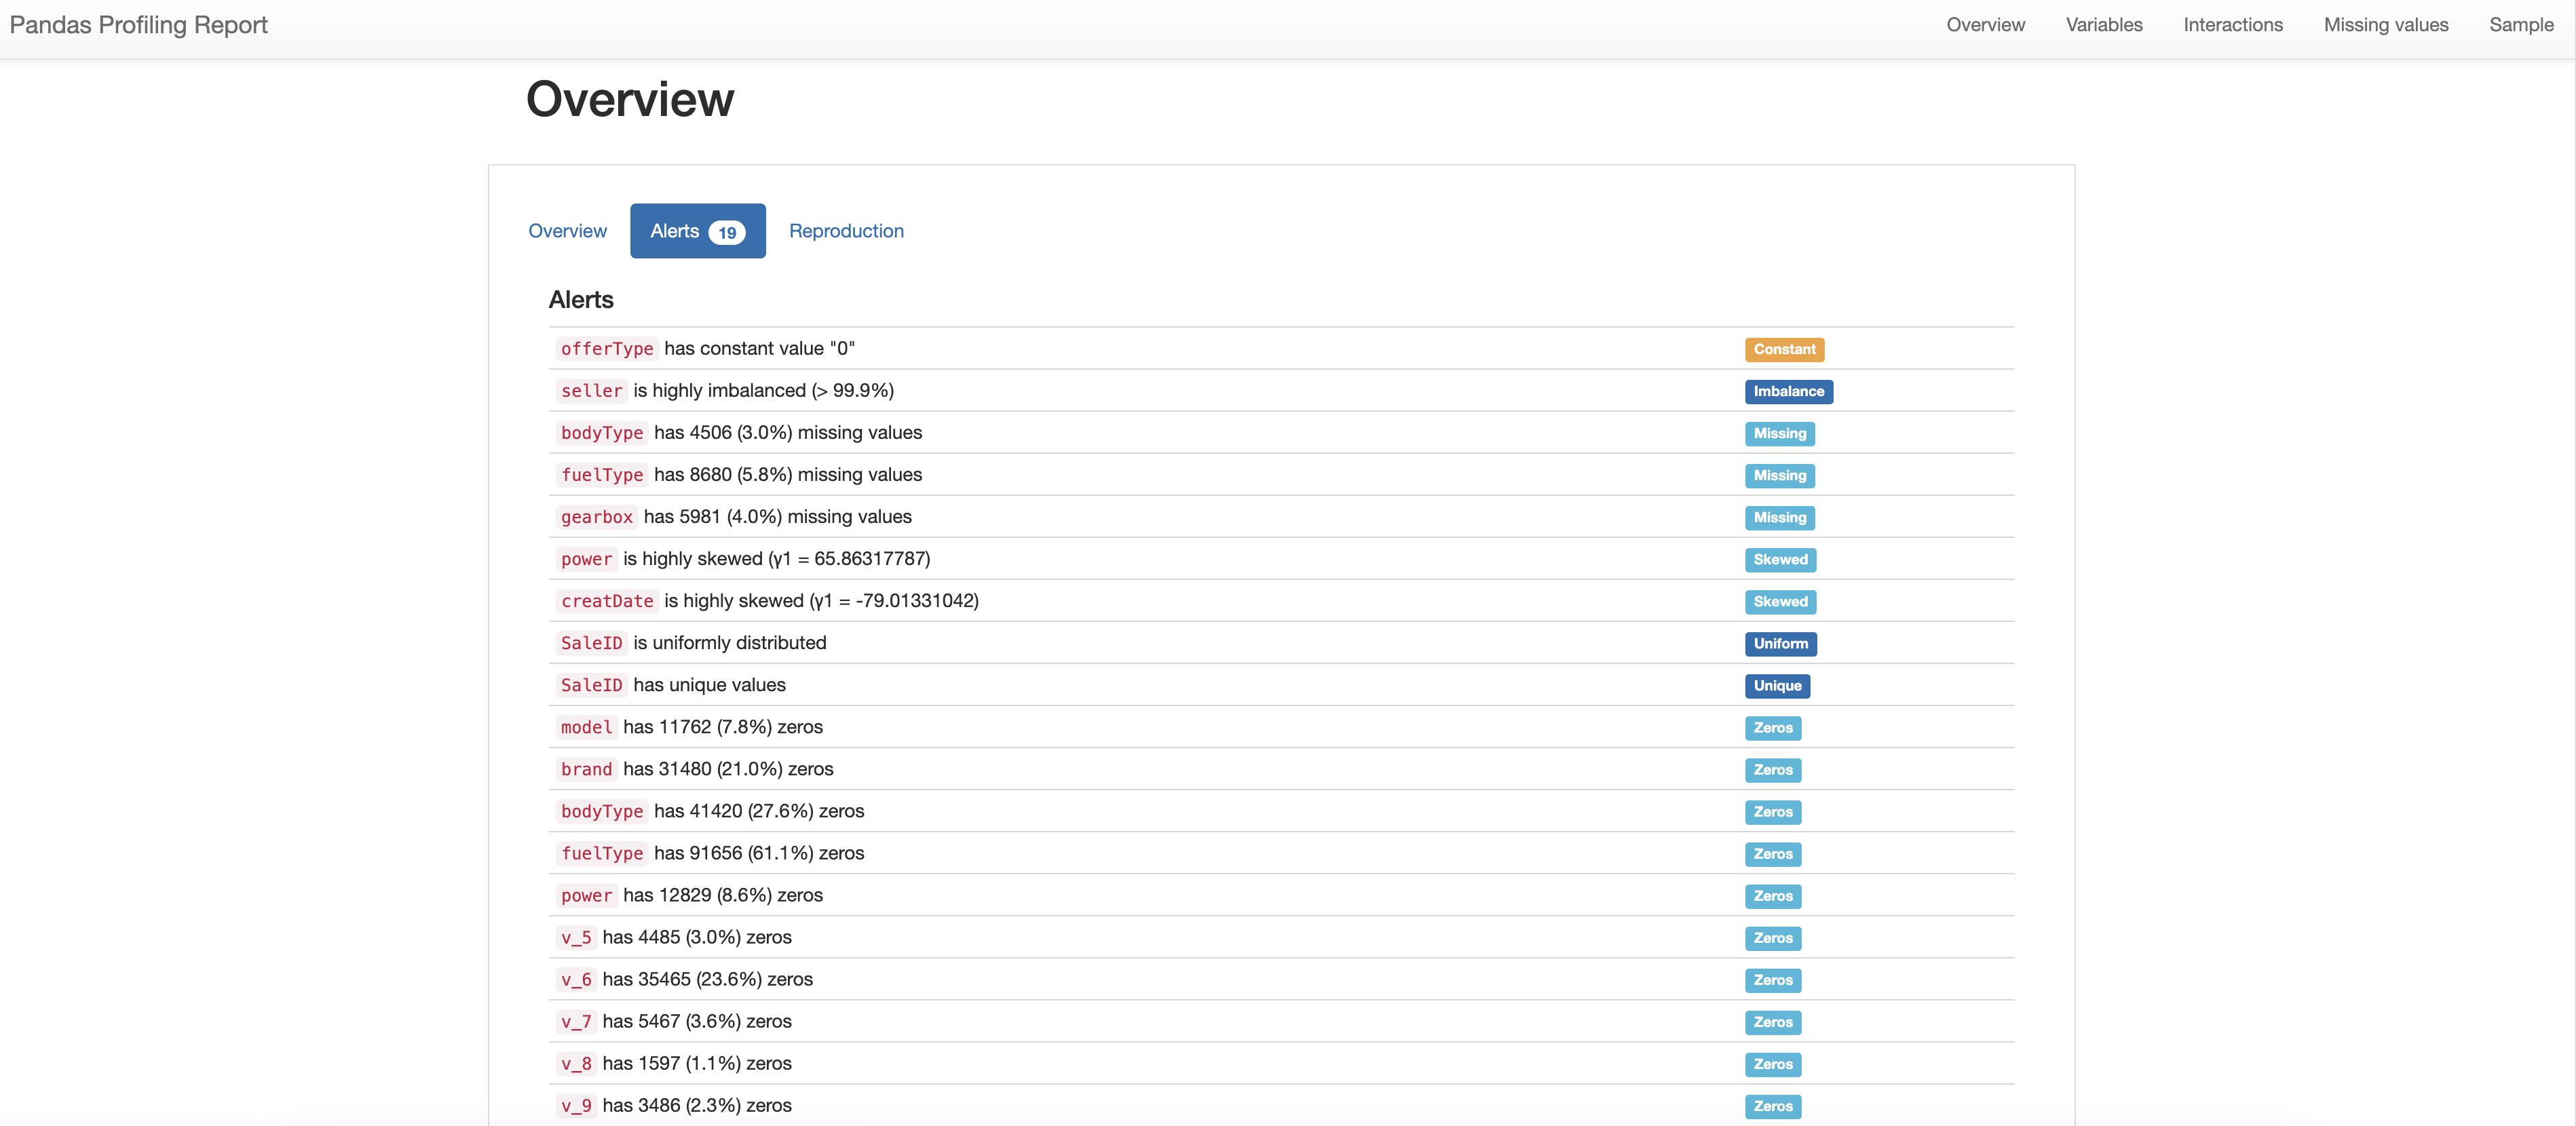
运行结果:
报告解析
在报告的Overview总览的Alert中,我们可以看到数据集的统计情况,包括:
- offerType has constant value "0"
offerType 存在数值为0的常量(通过查看数据字段中offerType字段主要就是0和1,这应该是合理的)
- seller is highly imbalanced (> 99.9%)
seller 提示存在严重不均衡(通过查看seller字段含义为个体或非个体,大多数情况下都是个体,这也是合理的)
- bodyType has 4506 (3.0%) missing values
- fuelType has 8680 (5.8%) missing values
- gearbox has 5981 (4.0%) missing values
bodyType、fuelType、gearbox存在数据缺失情况(稍后进行排查)
- power is highly skewed (γ1 = 65.86317787)
- creatDate is highly skewed (γ1 = -79.01331042)
power、creatDate字段,特征的分布是高度偏斜的(稍后进行排查)
- SaleID is uniformly distributed
- SaleID has unique values
SaleID字段,数据唯一(因为该字段是ID号,所以数据唯一是合理的)
- model has 11762 (7.8%) zeros
- brand has 31480 (21.0%) zeros
- ...
model、brand、bodyType、fuelType、power字段都存在0值(这是合理的)
通过以上的分析,我们可以看到数据集主要存在两个问题: 问题1:bodyType、fuelType、gearbox存在数据缺失情况
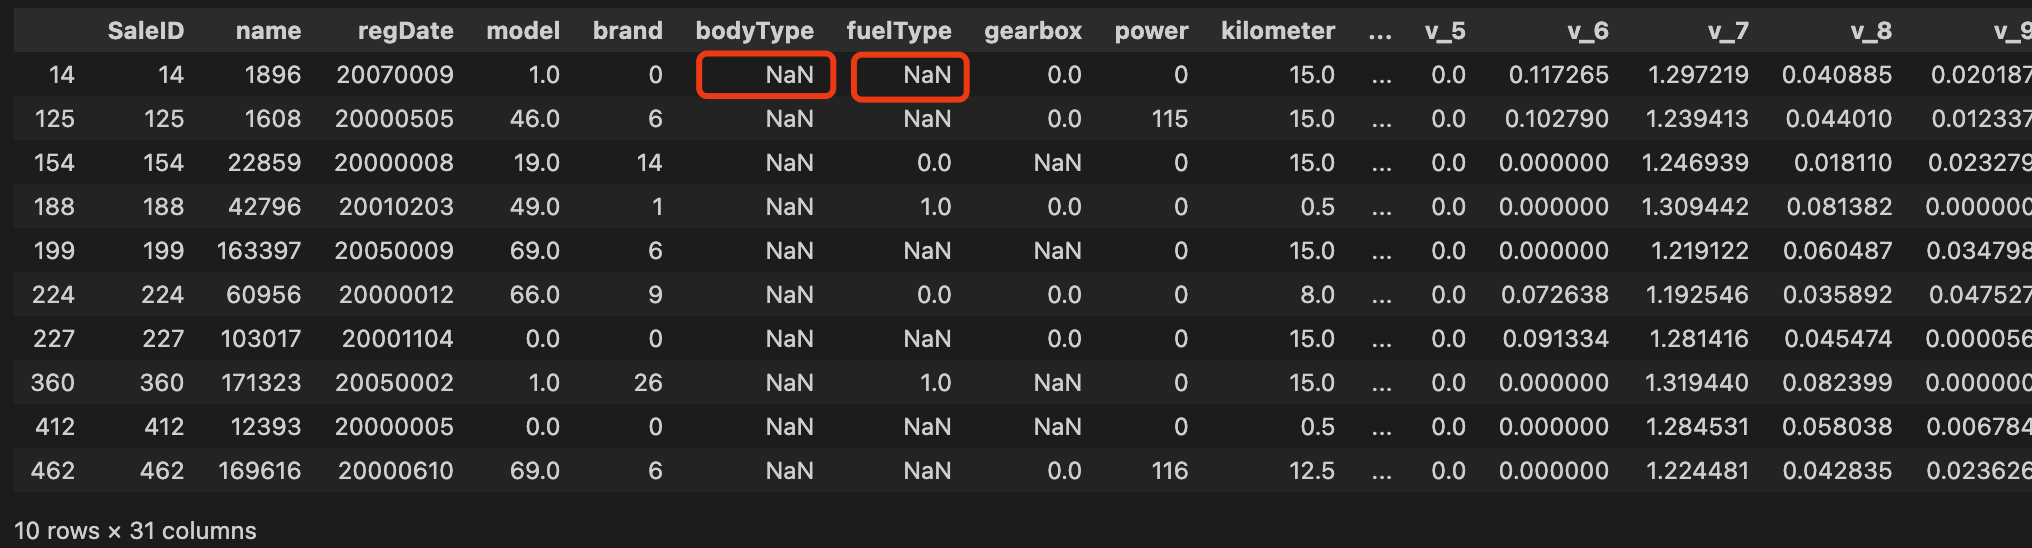
# 查看data中bodyType列Missing的数据
df['bodyType'].isnull().sum()

# 查看10条bodyType列Missing的数据
df[df['bodyType'].isnull()].head(10)
运行结果:的确存在内容为空的问题
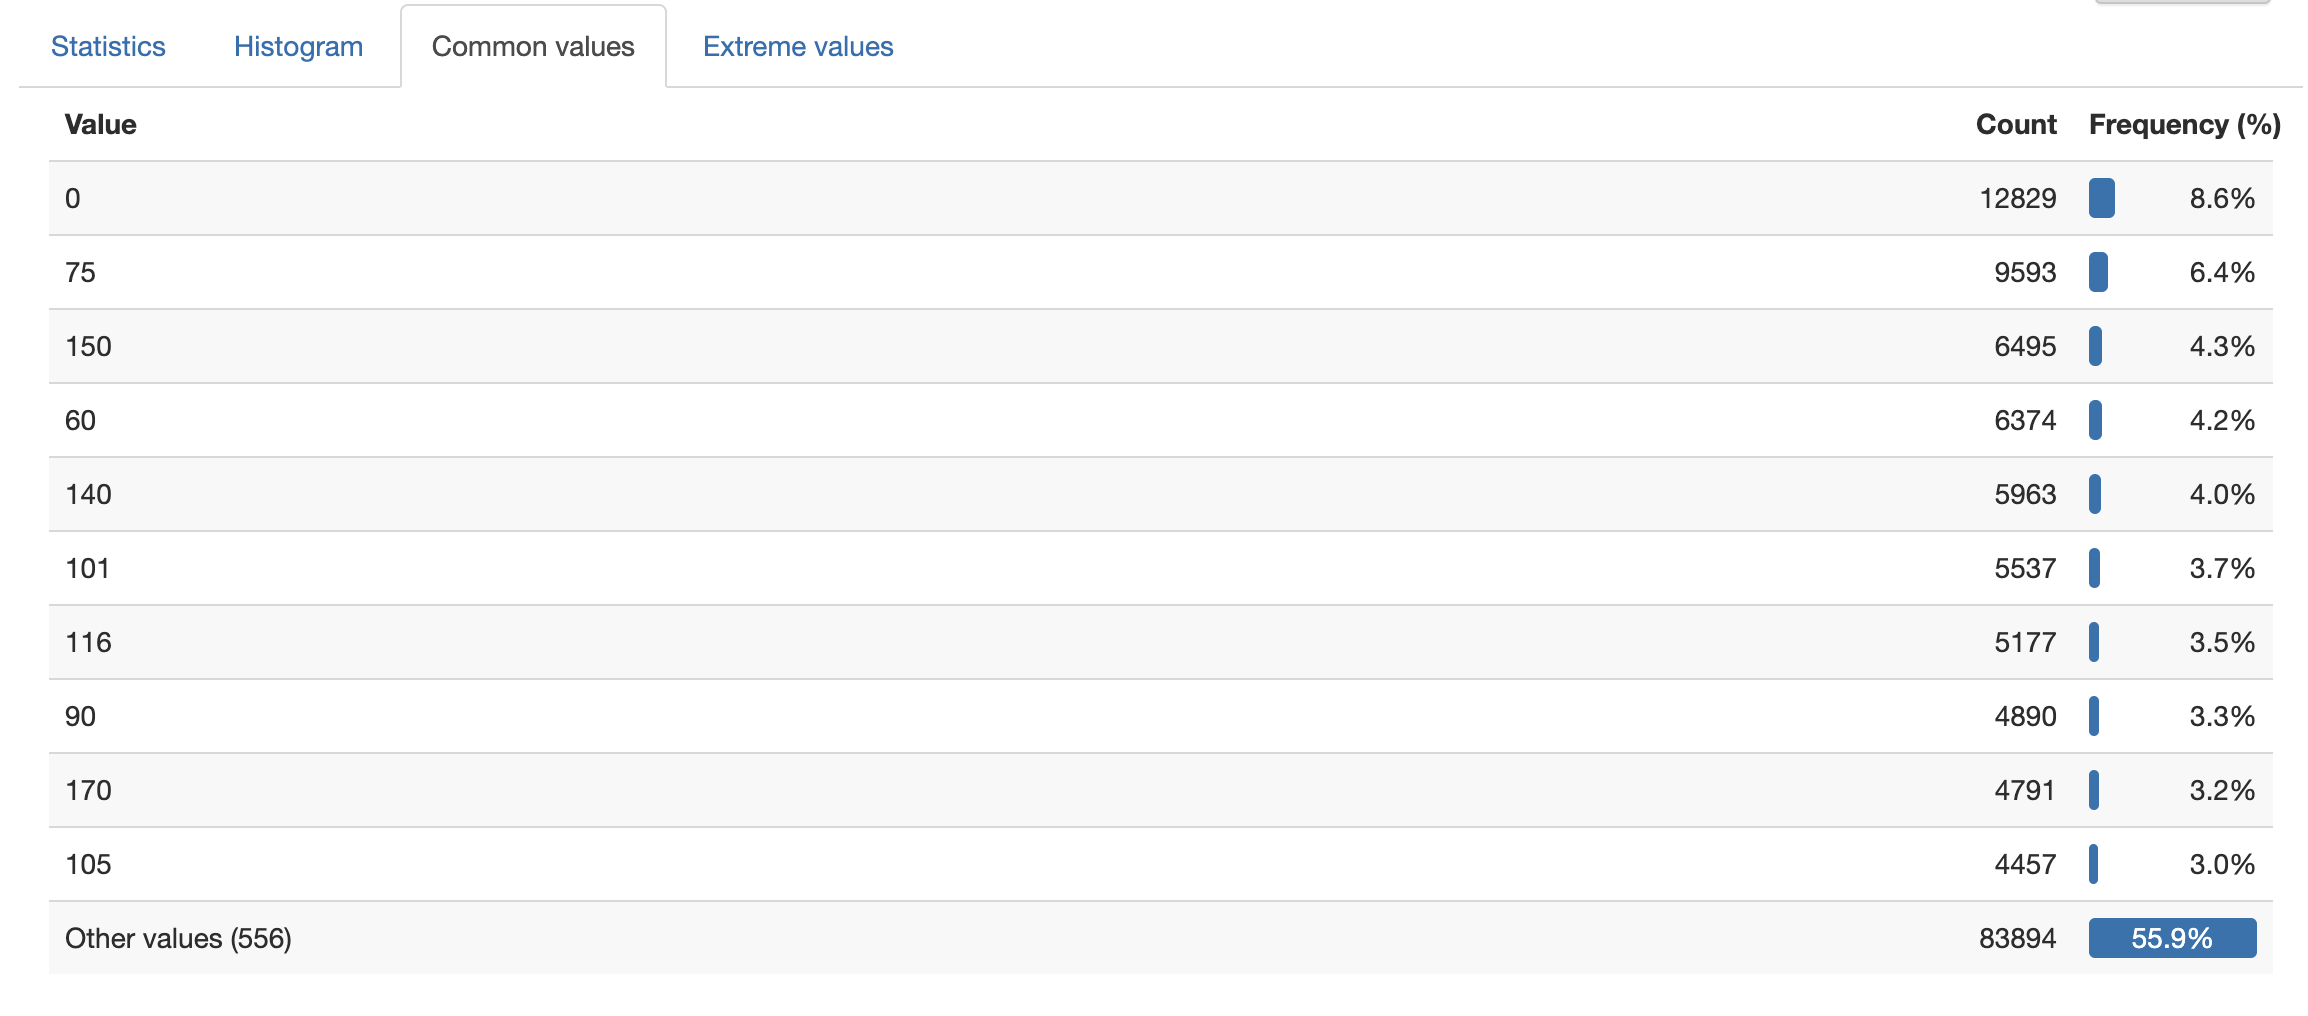
问题2:power、creatDate字段,特征的分布是高度偏斜的
在报告中点击查看power字段,由于该字段是表示发动机攻略,大部分攻略为556类型,所以看着应该是合理的。
小结:
- 通过ydata_profiling分析之后,数据集中主要的问题是bodyType、fuelType、gearbox存在数据缺失情况,需要后续进行清洗处理。
2. 数据预处理
2.1 离散量和连续量
| 字段 | 描述 | 类型 | 处理方法 |
|---|---|---|---|
| SaleID | 样本ID | 连续量 | 无 |
| name | 汽车交易名称(0~196793) | 连续量 | 无 |
| regDate | 汽车注册日期,例如:20160101 | 连续量 | 无 |
| model | 车型编码(0~250) | 连续量 | 无 |
| brand | 品牌编码(0~39) | 连续量 | 无 |
| bodyType | 车型(豪华轿车:0,微型车:1;...) | 离散量 | 去除空值 |
| fuelType | 燃油类型(汽油:0,柴油:1,液化石油气:2;...) | 离散量 | 去除空值 |
| gearbox | 变速箱(手动:0,自动:1) | 离散量 | 去除空值 |
| power | 发动机功率(0~600) | 连续量 | 无 |
| kilometers | 行驶里程 | 连续量 | 无 |
| notRepaired | 是否修复过(是:0,否:1) | 离散量 | 无 |
| regionCode | 地区编码(0~8100) | 连续量 | 无 |
| seller | 卖家类型(个体:0,非个体:1) | 离散量 | 无 |
| offerType | 卖家类型(提供:0,请去:1) | 离散量 | 无 |
| creatDate | 发布时间(例如:20160403) | 连续量 | 无 |
| v系列特征 | V系列特征 | 连续量 | 无 |
| price | 售价 | 连续量 | 无 |
2.2 处理空值
空值的处理方法有多种:
- 删除空值
- 使用0填充空值
- 使用中位数填充空值
在本次实战中,我们选择较为简单粗暴的方式:直接剔除空值的相应行。
代码文件:src/data_processing/data_processor.py
    def _preprocess_features(X: pd.DataFrame, y: pd.Series) -> tuple:
        """
        预处理特征数据,包括数据类型转换和处理缺失值

        Args:
            X (pd.DataFrame): 特征数据
            y (pd.Series): 目标变量

        Returns:
            tuple: (处理后的特征X, 处理后的目标变量y)
        """
        # 数据类型转换
        for column in X.columns:
            X[column] = pd.to_numeric(X[column], errors='coerce')

        # 剔除包含缺失值的行
        combined_df = pd.concat([X, pd.Series(y, name='target')], axis=1)
        combined_df = combined_df.dropna()
        X = combined_df.drop('target', axis=1)
        y = combined_df['target']

        return X, y
说明:
- 为了便于代码维护,我们创建一个DataProcessor类,用于处理数据,包括数据类型转换和处理缺失值。
- 该类中定义了_preprocess_features方法,用于处理数据,包括数据类型转换和处理缺失值。
- 由于在剔除空值时,需要同时剔除目标变量y,所以需要将X和y合并,然后剔除空值。
2.3 数据标准化
为了提升模型的训练效果,我们需要对数据进行标准化处理。
代码文件:src/data_processing/data_processor.py
    def prepare_data(self,X, y, test_size=0.2, random_state=0) -> tuple:
        """
        准备训练集和测试集,包括数据标准化

        Args:
            X: 特征数据
            y: 目标变量
            test_size: 测试集比例
            random_state: 随机种子

        Returns:
            tuple: (X_train_normalized, X_test_normalized, y_train_normalized, y_test_normalized)
        """
        # 预处理数据
        X, y = DataProcessor._preprocess_features(X, y)

        # 数据分割
        X_train, X_test, y_train, y_test = train_test_split(
            X, y, test_size=test_size, random_state=random_state
        )

        # 转换为numpy数组
        X_train_np = X_train.values
        X_test_np = X_test.values
        y_train_np = y_train.values
        y_test_np = y_test.values

        # 计算并保存统计量
        mean_X = X_train_np.mean(axis=0)
        std_X = X_train_np.std(axis=0)
        std_X[std_X == 0] = 1e-9

        mean_y = y_train_np.mean()
        std_y = y_train_np.std()
        if std_y == 0:
            std_y = 1e-9

        # 将统计量保存为类属性
        self.mean_X = mean_X
        self.std_X = std_X
        self.mean_y = mean_y
        self.std_y = std_y

        X_train_normalized = (X_train_np - mean_X) / std_X
        X_test_normalized = (X_test_np - mean_X) / std_X

        # y标签标准化
        y_train_normalized = (y_train_np - mean_y) / std_y
        y_test_normalized = (y_test_np - mean_y) / std_y

        return X_train_normalized, X_test_normalized, y_train_normalized, y_test_normalized
说明:
- 我们在DataProcessor类中定义了prepare_data方法,用于准备训练集和测试集,包括数据标准化。
- 该方法调用_preprocess_features方法,用于处理数据,包括数据类型转换和处理缺失值。
3. 模型训练
3.1 模型定义
我们通过搭建一个全链接的模型,用于预测二手车价格。
代码文件:src/models/car_price_model.py
import torch.nn as nn

class CarPriceModel(nn.Module):
    """
    二手车价格预测模型
    """
    def __init__(self, in_features=13, out_features=1):
        """
        初始化模型

        Args:
            in_features (int): 输入特征维度
            out_features (int): 输出维度
        """
        super(CarPriceModel, self).__init__()
        self.linear1 = nn.Linear(in_features, 64)
        self.relu1 = nn.ReLU()
        self.bn1 = nn.BatchNorm1d(64)

        self.linear2 = nn.Linear(64, 32)
        self.relu2 = nn.ReLU()
        self.bn2 = nn.BatchNorm1d(32)

        self.linear3 = nn.Linear(32, out_features)

    def forward(self, x):
        """
        前向传播
        """
        x = self.linear1(x)
        x = self.bn1(x)
        x = self.relu1(x)
        x = self.linear2(x)
        x = self.bn2(x)
        x = self.relu2(x)
        x = self.linear3(x)
        return x
3.2 数据集定义
我们创建一个CarPriceDataset类,用于定义数据集,以便后续模型训练时使用。
代码文件:src/datasets/car_price_dataset.py
import torch
from torch.utils.data import Dataset, DataLoader
import numpy as np

class CarPriceDataset(Dataset):
    """二手车数据集类"""
    def __init__(self, X, y):
        """
        初始化数据集

        Args:
            X: 特征数据
            y: 目标变量
        """
        self.X = X
        self.y = y.to_numpy() if not isinstance(y, np.ndarray) else y

    def __len__(self):
        return len(self.X)

    def __getitem__(self, idx):
        return (torch.tensor(self.X[idx], dtype=torch.float32),
                torch.tensor(self.y[idx], dtype=torch.float32))
3.3 数据加载器
代码文件:src/datasets/car_price_dataset.py
def create_data_loaders(X_train, X_test, y_train, y_test, batch_size_train=12, batch_size_test=32):
    """
    创建数据加载器

    Args:
        X_train: 训练集特征
        X_test: 测试集特征
        y_train: 训练集标签
        y_test: 测试集标签
        batch_size_train: 训练批次大小
        batch_size_test: 测试批次大小

    Returns:
        tuple: (训练数据加载器, 测试数据加载器)
    """

    # 在 create_data_loaders 函数中,确保 y 值被重塑为 2D 张量
    y_train = y_train.reshape(-1, 1)
    y_test = y_test.reshape(-1, 1)

    train_dataset = CarPriceDataset(X_train, y_train)
    test_dataset = CarPriceDataset(X_test, y_test)

    train_loader = DataLoader(train_dataset, batch_size=batch_size_train, shuffle=True)
    test_loader = DataLoader(test_dataset, batch_size=batch_size_test, shuffle=False)

    return train_loader, test_loader
3.4 模型训练器
为了方便模型训练,我们创建一个ModelTrainer类,管理训练过程中的模型、损失函数、优化器、设备等。
代码文件:src/training/trainer.py
import torch
import logging
import matplotlib.pyplot as plt

class ModelTrainer:
    """
    模型训练器类
    """
    def __init__(self, model, loss_fn, optimizer, device):
        """
        初始化训练器

        Args:
            model: 神经网络模型
            loss_fn: 损失函数
            optimizer: 优化器
            device: 训练设备
        """
        self.model = model
        self.loss_fn = loss_fn
        self.optimizer = optimizer
        self.device = device

    def evaluate_model(self, dataloader):
        """
        评估模型

        Args:
            dataloader: 数据加载器

        Returns:
            float: 平均损失值
        """
        self.model.eval()
        losses = []

        with torch.no_grad():
            for X, y in dataloader:
                X, y = X.to(self.device), y.to(self.device)
                y_pred = self.model(X)
                loss = self.loss_fn(y_pred, y)
                losses.append(loss.item())

        return round(sum(losses) / len(losses), 5)

    def train(self, train_loader, test_loader, epochs, progress_callback=None):
        """
        训练模型

        Args:
            train_loader: 训练数据加载器
            test_loader: 测试数据加载器
            epochs: 训练轮数
            progress_callback: 进度回调函数
        """
        train_losses = []
        test_losses = []

        for epoch in range(epochs):
            self.model.train()
            epoch_losses = []

            for batch_idx, (X, y) in enumerate(train_loader):
                X, y = X.to(self.device), y.to(self.device)

                y_pred = self.model(X)
                loss = self.loss_fn(y_pred, y)

                self.optimizer.zero_grad()
                loss.backward()
                self.optimizer.step()

                epoch_losses.append(loss.item())

            train_loss = self.evaluate_model(train_loader)
            test_loss = self.evaluate_model(test_loader)

            train_losses.append(train_loss)
            test_losses.append(test_loss)

            # 使用回调函数更新进度
            if progress_callback:
                progress_callback(epoch, train_loss, test_loss)

            logging.info(f'Epoch {epoch+1}/{epochs} - train_loss: {train_loss:.5f}, test_loss: {test_loss:.5f}')

        return train_losses, test_losses
3.5 模型训练
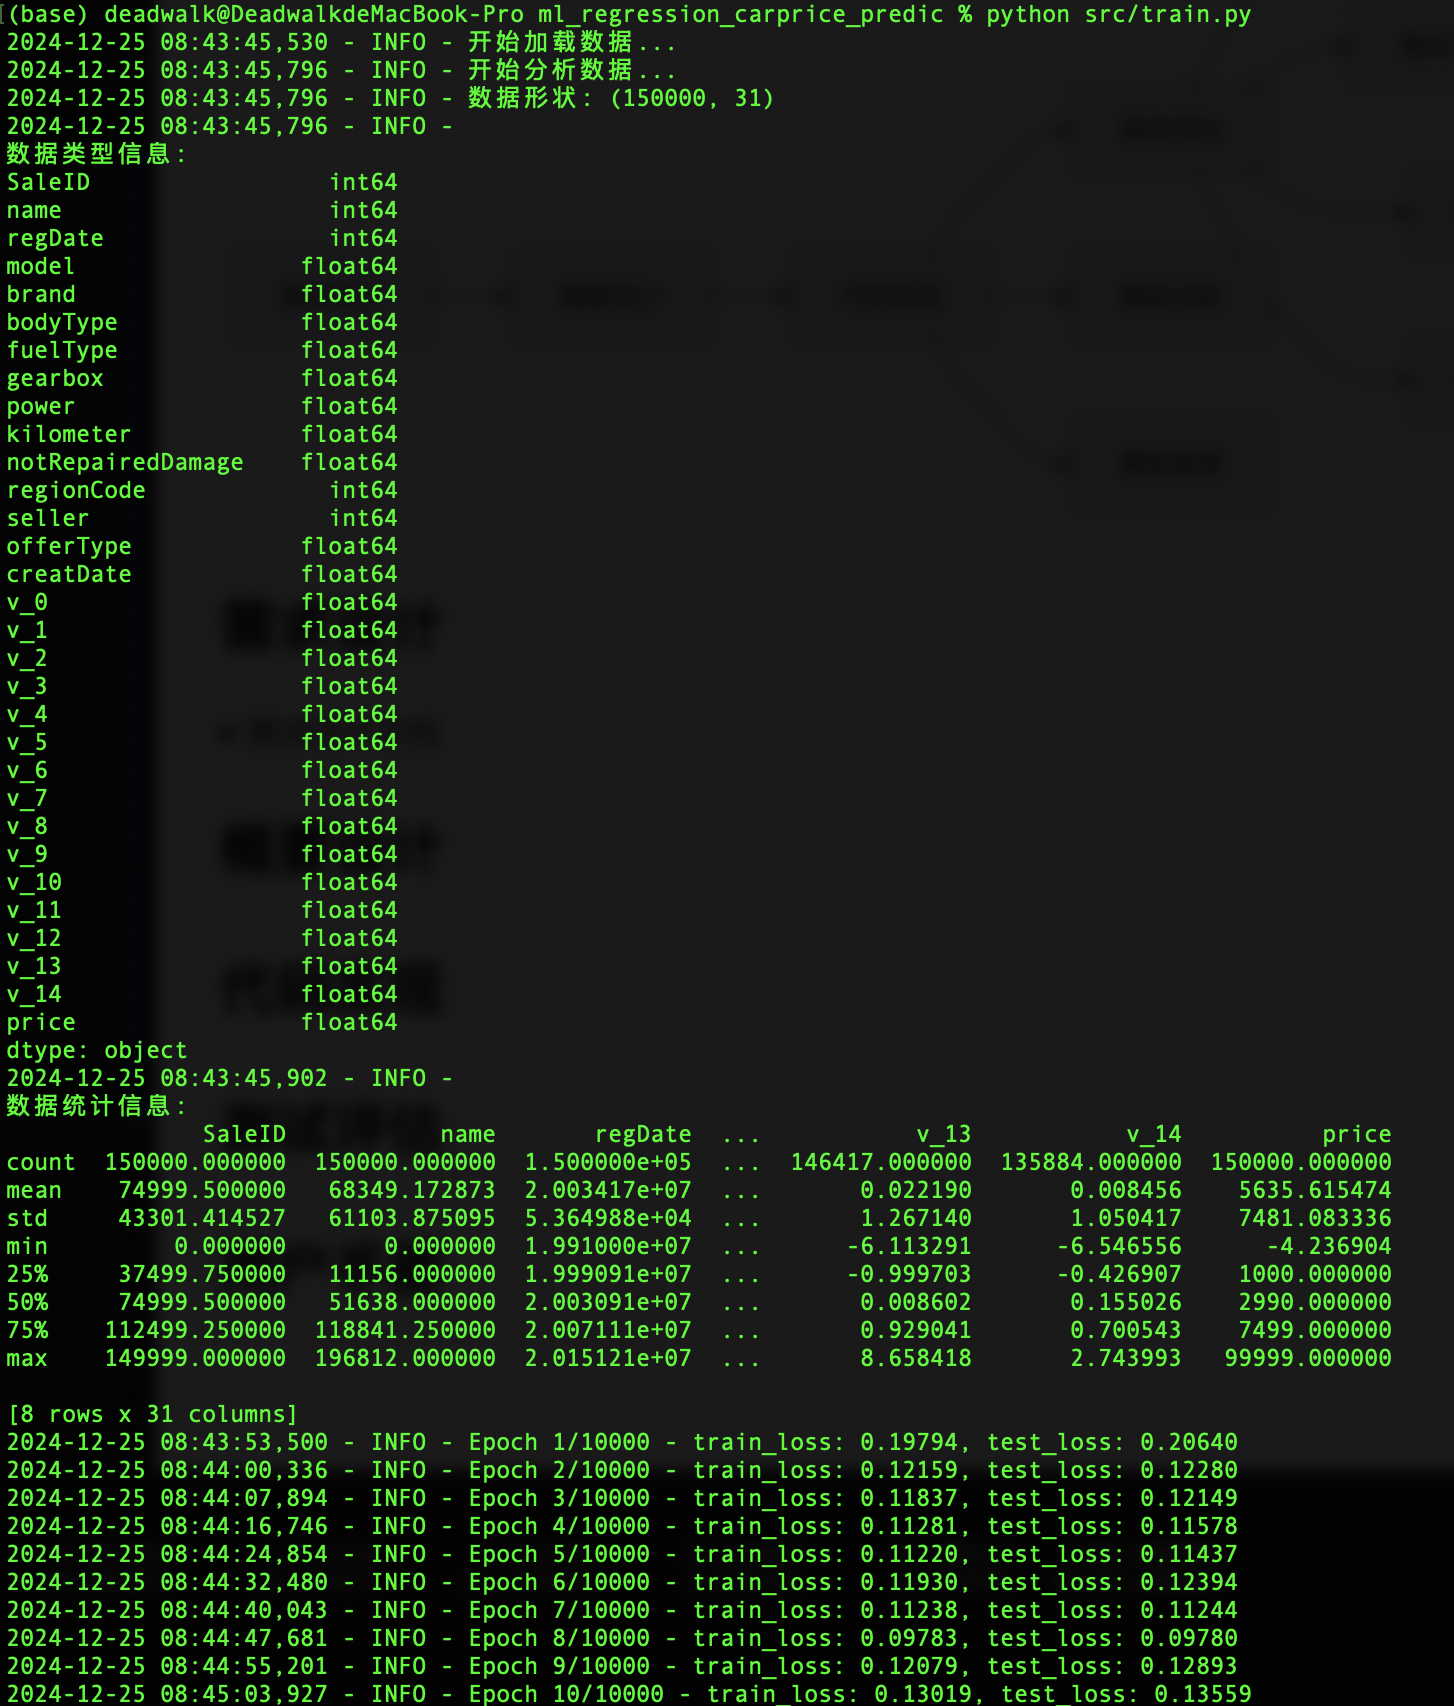
在准备好相关的模型、数据集、数据加载器、训练器之后,我们就可以开始训练模型了。 训练过程主要是:
- 设置日志
- 数据处理
- 创建数据加载器
- 设置设备
- 初始化模型
- 设置训练参数
- 创建训练器并训练模型
代码文件:src/train.py
import os
import torch
import torch.nn as nn
from data_processing.data_processor import DataProcessor
from models.car_price_model import CarPriceModel
from datasets.car_price_dataset import create_data_loaders
from training.trainer import ModelTrainer

def train_car_price_model(data_input: str,
                         model_save_path: str = 'model.pth',
                         plot_save_path: str = 'loss_curve.png',
                         epochs: int = 10000,
                         learning_rate: float = 1e-4,
                         progress_callback=None):

    # 数据处理
    processor = DataProcessor()

    # 根据输入类型处理数据
    if isinstance(data_input, str):
        # 如果输入是文件路径
        X, y = processor.load_and_analyze_data(data_input)
    else:
        # 如果输入是DataFrame
        X, y = processor.load_and_analyze_data(data_input)

    X_train, X_test, y_train, y_test = processor.prepare_data(X, y)

    # 创建数据加载器
    train_loader, test_loader = create_data_loaders(X_train, X_test, y_train, y_test)

    # 设置设备
    device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')

    # 初始化模型
    model = CarPriceModel(in_features=X_train.shape[1], out_features=1)
    model = model.to(device)

    # 设置训练参数
    loss_fn = nn.MSELoss()
    optimizer = torch.optim.Adam(model.parameters(), lr=learning_rate)

    # 创建训练器并训练模型
    trainer = ModelTrainer(model, loss_fn, optimizer, device)
    train_losses, test_losses = trainer.train(
        train_loader,
        test_loader,
        epochs,
        progress_callback=progress_callback
    )

    # 保存模型和损失曲线
    trainer.save_model(model_save_path)
    trainer.plot_losses(train_losses, test_losses, plot_save_path)

    return model, train_losses, test_losses, processor

if __name__ == "__main__":
    current_dir = os.getcwd()
    data_path = os.path.join(current_dir, 'data', 'used_car_train_20200313_cleaned.csv')
    model, train_losses, test_losses = train_car_price_model(data_path)
备注:
used_car_train_20200313_cleaned.csv是经过数据处理后的数据,包含特征和目标变量。model.pth是训练完成之后,保存的模型,保存了模型的参数。loss_curve.png是训练过程中,训练损失和测试损失的变化曲线图。
运行结果:
4. 模型推理
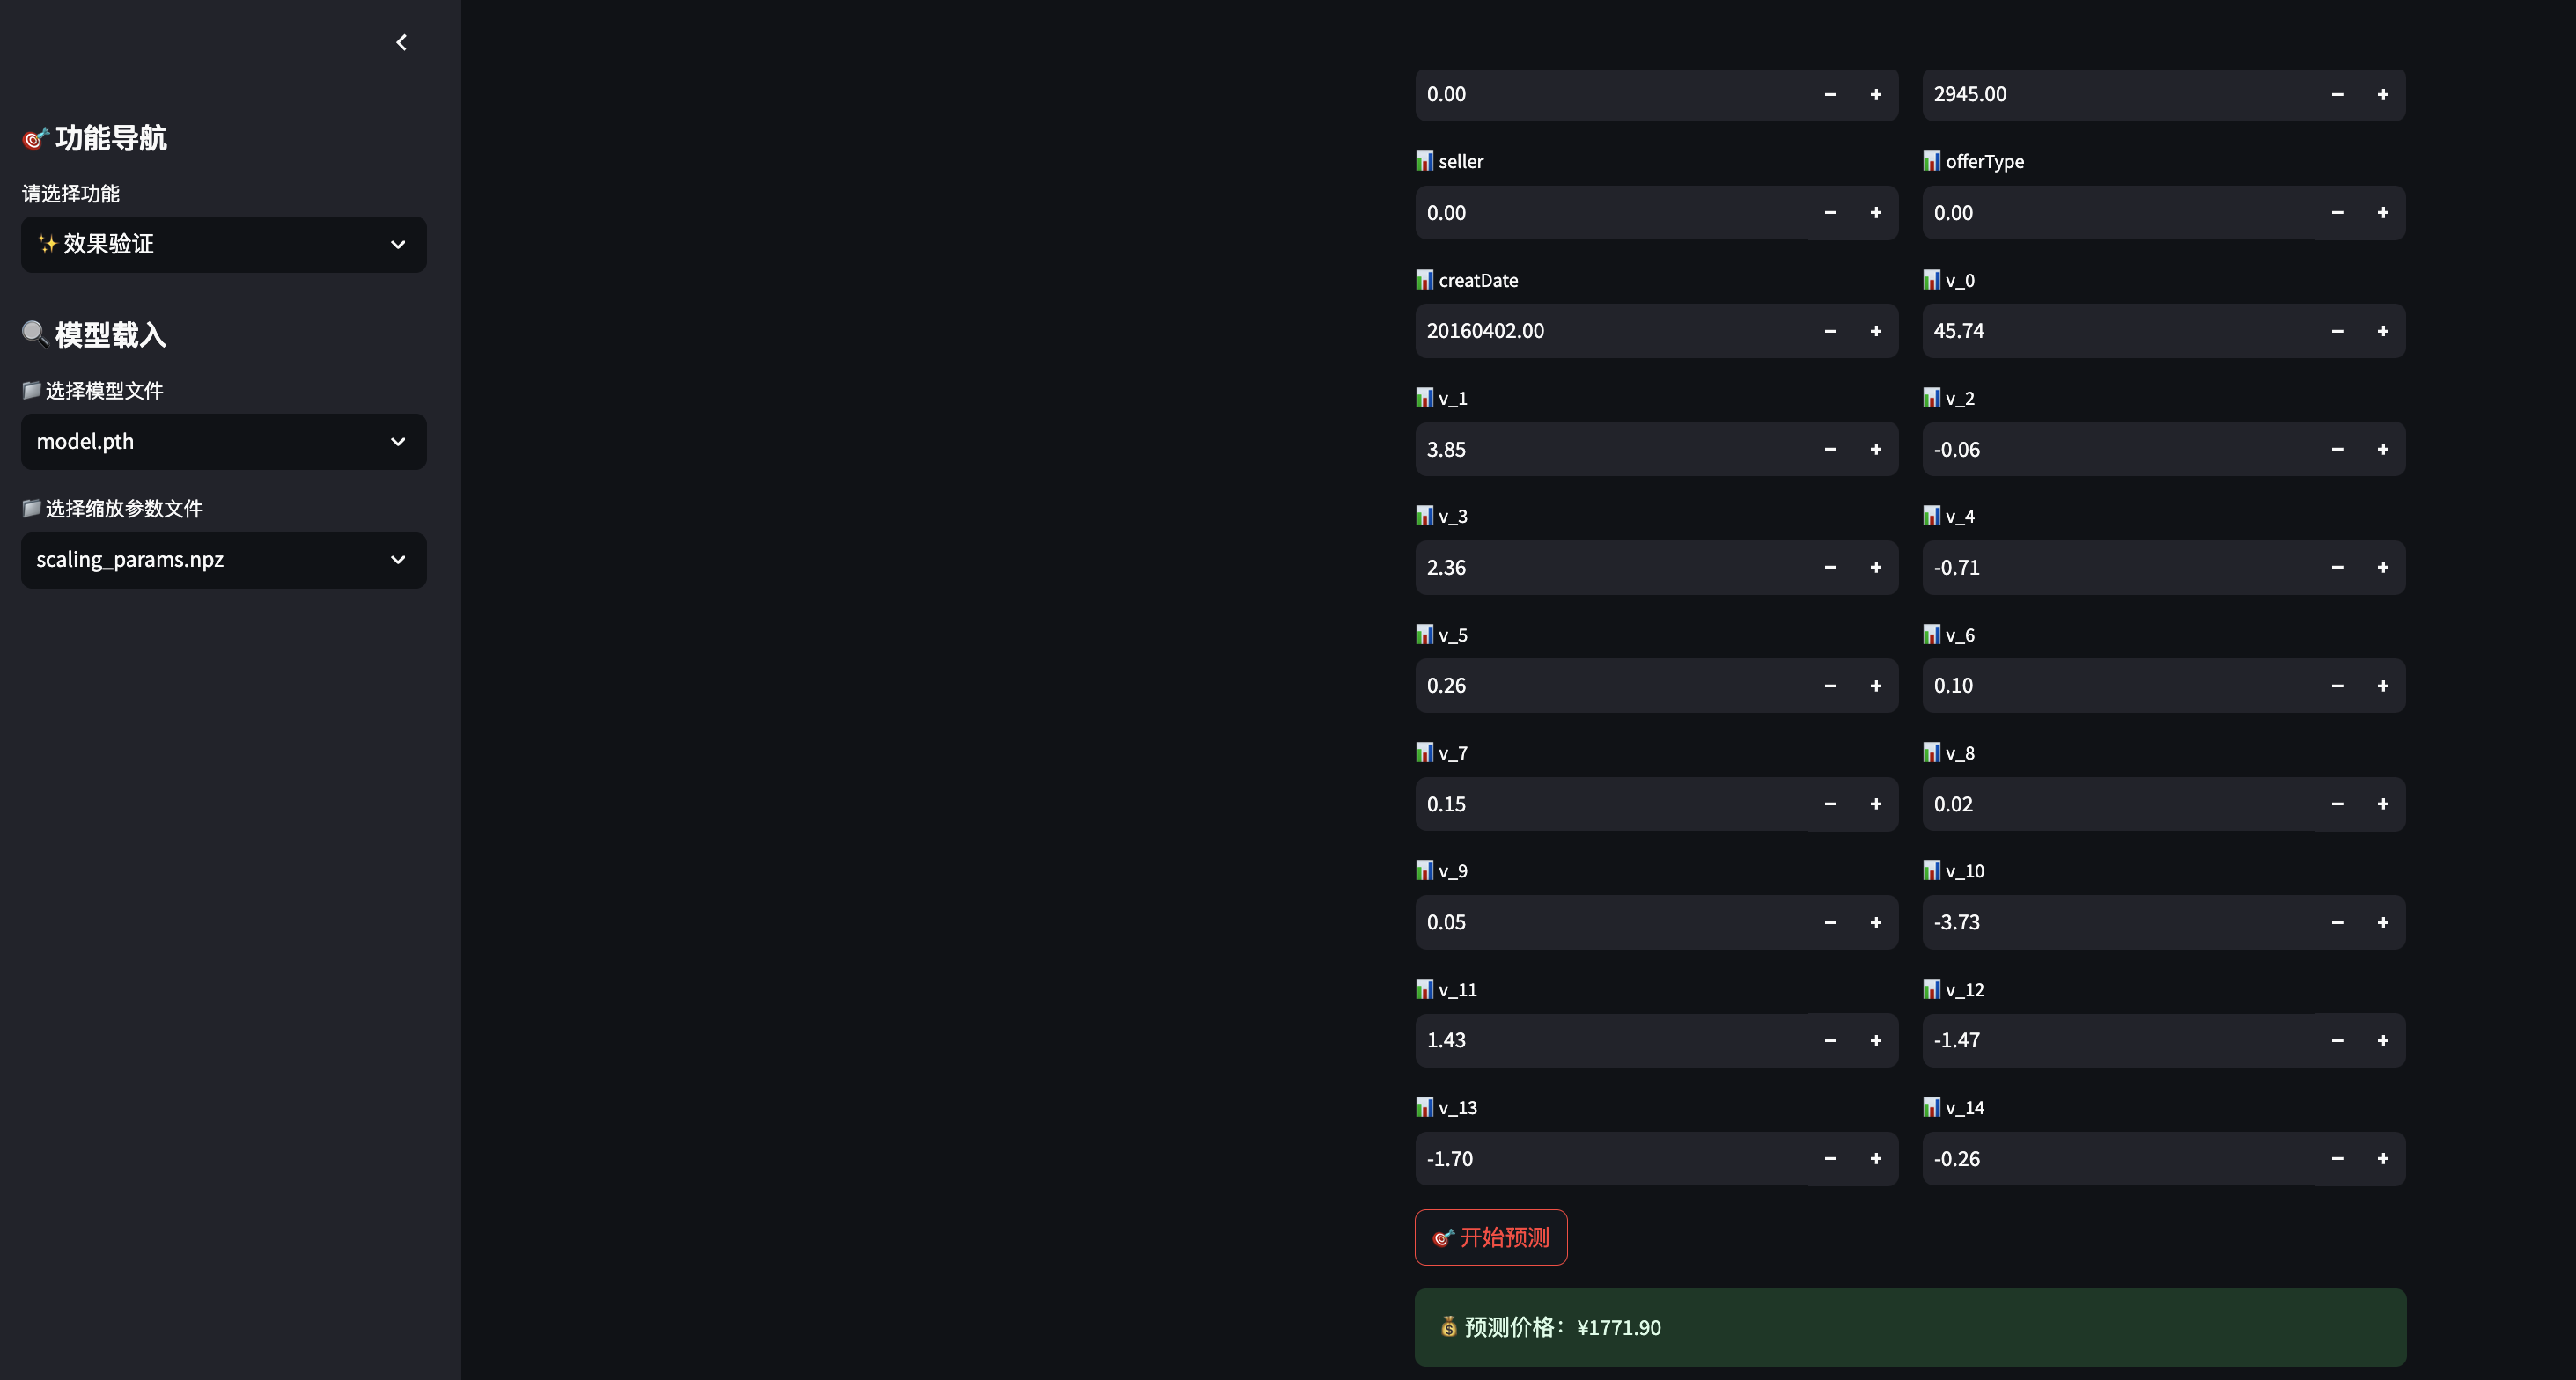
为了便于模型推理演示,我们通过streamlit创建一个web应用,用于展示模型推理过程。
由于该过程涉及较为繁琐的代码重构以及streamlit调试,详细过程不再赘述。
运行效果:
项目资料
为了便于后续的深度学习中级认证考试,本次我们也将项目相关资料进行梳理,以供参考。
- 需求设计文档
- 概要设计文档
- 测试方案文档
- 测试报告文档
- 用户手册文档
需求设计文档
引言
编写目的
本需求规格说明书旨在明确二手车价格预测模型项目的目标、需求和实现方案。通过详细描述项目的背景、功能需求、非功能需求及相关约束条件,为项目的开发、测试和后续维护提供清晰的指导。文档将作为项目团队、利益相关者和用户之间的沟通桥梁,确保各方对项目目标和实施方案的理解一致。
项目背景
随着二手车市场的快速发展,消费者在购买二手车时面临着价格不透明的问题。传统的价格评估方法往往依赖于经验和市场行情,缺乏科学依据。通过深度学习技术,可以有效地分析历史交易数据,提取车辆特征与价格之间的关系,从而实现对二手车价格的准确预测。该项目旨在构建一个基于深度学习的二手车价格预测模型,帮助消费者做出更明智的决策,提升二手车交易的透明度和效率。
术语定义和缩写语
- 深度学习(Deep Learning):一种机器学习方法,通过多层神经网络对数据进行特征提取和模式识别。
- 二手车(Used Car):已经被购买并再次出售的汽车。
- 价格预测(Price Prediction):根据输入特征(如品牌、型号、年份等)预测商品的市场价格。
- 数据预处理(Data Preprocessing):对原始数据进行清洗、转换和整理的过程,以便于后续分析和建模。
- 探索性数据分析(Exploratory Data Analysis, EDA):对数据集进行初步分析,以发现数据的特征、模式潜在问题。
- 模型训练(Model Training):使用训练数据对机器学习模型进行学习的过程,以优化模型参数。
参考资料
- 在线资源:
- CSDN:超全总结!探索性数据分析 (EDA)方法汇总!
- 阿里天池数据集下载
- 工具和库:
- ydata-profiling:用于自动化生成数据集的详细报告的Python库。
- pandas:用于数据处理和分析的Python库。
- PyTorch:用于深度学习的开源框架。
任务概述
建设目标
本项目旨在构建一个基于深度学习的二手车价格预测模型,能够根据车辆的各项特征(如品牌、型号、年份、里程等)准确预测其市场价格。
建设内容
本项目旨在构建一个基于深度学习的二手车价格预测模型,具体建设内容包括:
-
数据处理:
- 二手车交易数据,进行可视化数据分析、数据清洗、缺失值处理和异常值检测。
- 进行数据预处理,包括特征选择、特征工程和数据标准化。
-
模型构建与训练:
- 设计并实现深度学习模型,选择合适的网络结构(如全连接神经网络)。
- 使用训练集对模型进行训练,并通过验证集调整超参数。
-
模型评估与优化:
- 评估模型性能,使用均方误差(MSE)等指标进行评估。
- 根据评估结果进行模型优化,提升预测准确性。
-
模型推理与应用:
- 实现模型推理功能,能够根据用户输入的车辆特征预测价格。
- 开发Web应用(如使用Streamlit)展示模型推理结果,提供用户友好的界面。
-
文档与用户手册:
- 编写项目文档,包括需求规格说明书、设计文档和用户手册。
- 提供详细的使用说明和示例,帮助用户理解和使用模型。
功能需求
-
需求编号:FR1 需求内容:数据处理功能 需求描述:
- 能够读取多种格式的二手车数据(如CSV)。
- 自动检测并处理缺失值和异常值。
- 提供数据可视化功能,展示数据分布和特征关系。
-
需求编号:FR2 需求内容:模型训练功能 需求描述:
- 支持全连接神经网络深度学习模型的训练。
- 提供超参数调整功能,支持不同的学习率、批次大小等设置。
- 能够保存和加载训练好的模型。
- 能够保存训练过程中的损失曲线。
- 能够实时显示训练过程中的损失变化。
-
需求编号:FR3 需求内容:模型推理功能 需求描述:
- 根据用户输入的车辆特征(如品牌、型号、年份等)进行价格预测。
- 提供预测结果的可视化展示,帮助用户理解预测结果。
-
需求编号:FR4 需求内容:用户界面功能 需求描述:
- 提供友好的Web界面,用户可以方便地输入车辆特征并获取预测结果。
- 显示模型的性能指标和预测结果的置信区间。
性能需求
-
需求编号:PR1 需求内容:预测准确性 需求描述:
-
本项目的预测准确性将通过均方误差(Mean Squared Error, MSE)来评估。MSE是衡量预测值与实际值之间差异的常用指标,其计算公式为:
MSE = \frac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2其中,(y_i) 是实际值,(\hat{y}_i) 是预测值,(n) 是样本数量。
-
在本项目中,MSE的取值范围设定在0.01到0.1之间。具体来说:
- 当MSE小于0.01时,表示模型的预测非常准确,能够很好地拟合数据。
- 当MSE在0.01到0.1之间时,表示模型的预测效果良好,能够接受。
- 当MSE大于0.1时,表示模型的预测效果较差,需要进一步优化。
-
为了确保模型的预测准确性,我们将采用以下评估方法:
- 交叉验证:使用K折交叉验证方法,将数据集分为K个子集,依次使用每个子集作为测试集,其余子集作为训练集,计算每次的MSE,最终取平均值作为模型的评估指标。
- 训练集与测试集划分:将数据集划分为训练集和测试集,通常采用80%作为训练集,20%作为测试集。训练模型后,在测试集上计算MSE,以评估模型的泛化能力。
- 可视化分析:通过绘制预测值与实际值的散点图,观察模型的预测效果,进一步分析MSE的合理性。
-
通过以上评估方法,我们将确保模型的预测准确性达到预期标准,并为后续的模型优化提供依据。
-
-
需求编号:PR2 需求内容:响应时间 需求描述:
- 模型推理的响应时间应小于2秒,确保用户体验流畅。
-
需求编号:PR4 需求内容:可扩展性 需求描述:
- 系统应支持后续功能扩展,如增加新的特征、支持更多数据源等。
用户界面需求
-
需求编号:UIR1 需求内容:输入界面 需求描述:
- 提供简洁明了的输入表单,用户可以输入车辆的各项特征(如品牌、型号、年份、里程等)。
- 输入框应具备数据验证功能,确保用户输入的格式正确。
-
需求编号:UIR2 需求内容:结果展示 需求描述:
- 显示预测结果,包括预测价格和相关的置信区间。
- 提供可视化图表,展示预测结果与实际价格的对比。
-
需求编号:UIR3 需求内容:用户反馈 需求描述:
- 提供反馈机制,用户可以对预测结果进行评价,帮助改进模型。
-
需求编号:UIR4 需求内容:帮助文档 需求描述:
- 提供在线帮助文档,用户可以随时查看使用说明和常见问题解答。
概要设计文档
文档介绍
文档目的
本文档旨在:
- 描述二手车价格预测系统的总体架构设计
- 明确系统各个模块的功能和接口
- 为后续详细设计和开发提供指导
- 作为项目团队成员之间沟通的基准
文档范围
本文档涵盖:
- 系统整体架构
- 核心功能模块设计
- 关键接口定义
- 数据流程设计
- 部署方案
读者对象
- 项目开发人员
- 项目管理人员
- 测试人员
- 运维人员
术语与解释
| 术语 | 解释 |
|---|---|
| EDA | Exploratory Data Analysis,探索性数据分析 |
| MSE | Mean Squared Error,均方误差,用于评估模型预测效果 |
| BatchNorm | Batch Normalization,批量归一化,用于加速模型训练 |
| DataFrame | pandas库中的二维表格数据结构 |
| Tensor | PyTorch中的多维数组数据结构 |
参考资料
- PyTorch官方文档: https://pytorch.org/docs/
- Streamlit官方文档: https://docs.streamlit.io/
- pandas官方文档: https://pandas.pydata.org/docs/
- 阿里天池数据集文档: https://tianchi.aliyun.com/dataset/dataDetail?dataId=95
总体设计
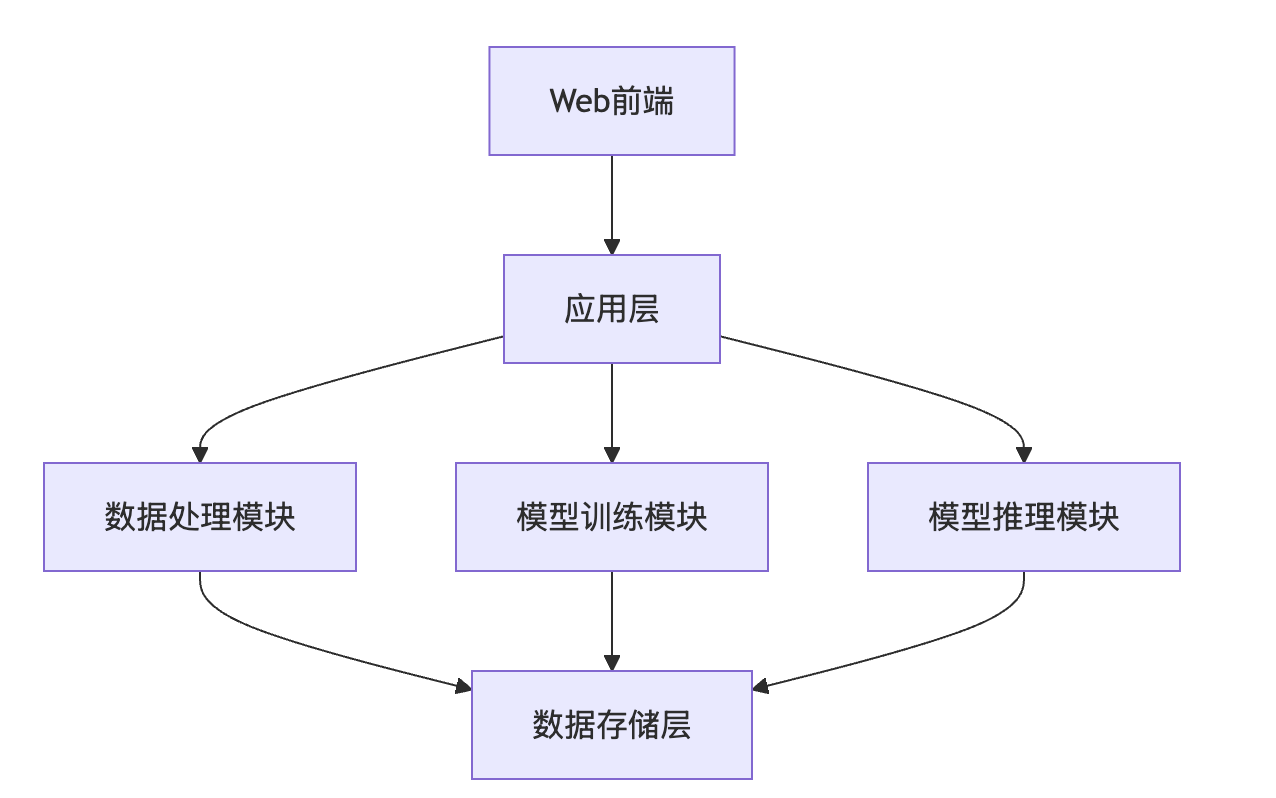
系统架构设计
- 系统整体架构
graph TB
A[Web前端] --> B[应用层]
B --> C1[数据处理模块]
B --> C2[模型训练模块]
B --> C3[模型推理模块]
C1 --> D[数据存储层]
C2 --> D
C3 --> D
说明: 以上内容为markdown的流程图绘制,使用任意支持markdown笔记mermaid功能的,均可绘制为如下图内容
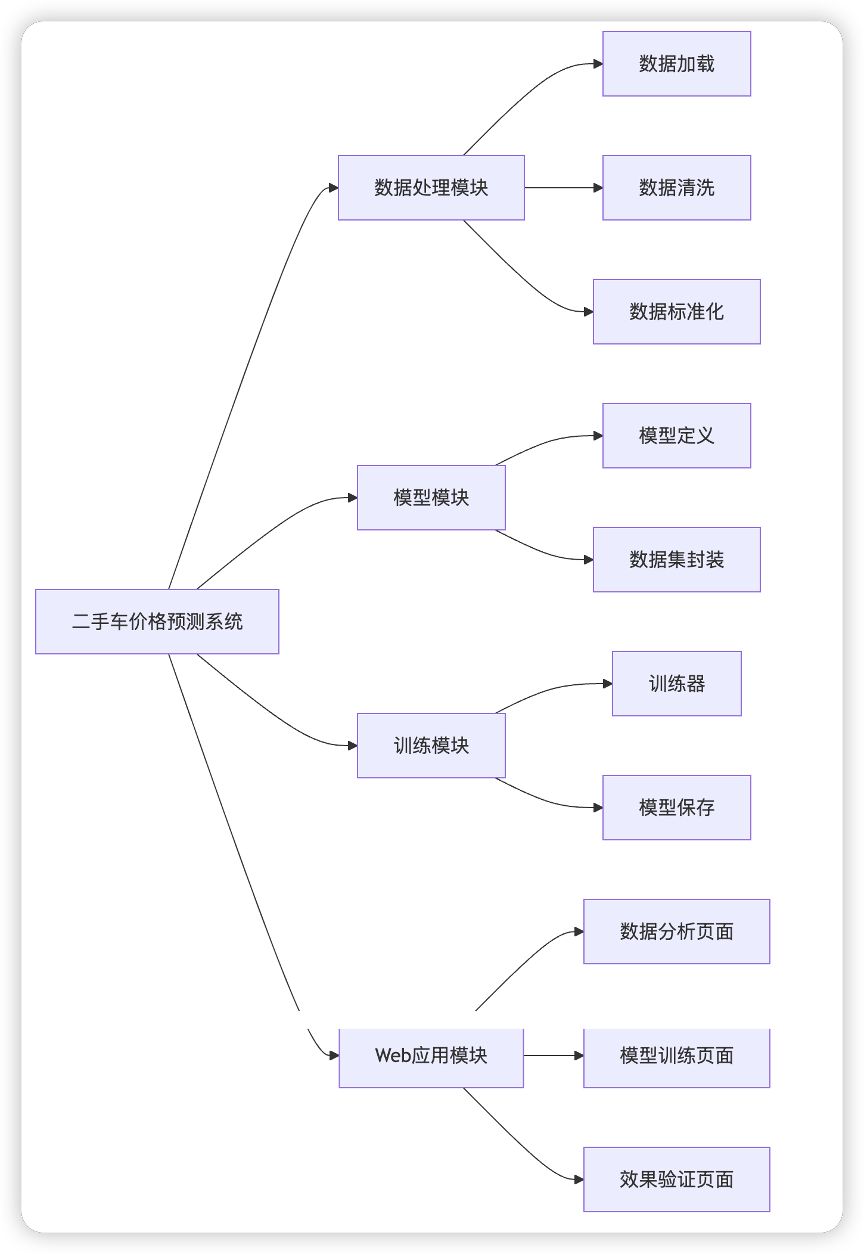
- 模块划分
graph LR
A[二手车价格预测系统] --> B1[数据处理模块]
A --> B2[模型模块]
A --> B3[训练模块]
A --> B4[Web应用模块]
B1 --> C1[数据加载]
B1 --> C2[数据清洗]
B1 --> C3[数据标准化]
B2 --> D1[模型定义]
B2 --> D2[数据集封装]
B3 --> E1[训练器]
B3 --> E2[模型保存]
B4 --> F1[数据分析页面]
B4 --> F2[模型训练页面]
B4 --> F3[效果验证页面]
开发工具
| 类别 | 工具 | 版本 | 用途 |
|---|---|---|---|
| 开发语言 | Python | 3.8+ | 主要开发语言 |
| 深度学习框架 | PyTorch | 2.0+ | 模型开发与训练 |
| Web框架 | Streamlit | 1.24+ | 前端界面开发 |
| 数据处理 | pandas | 1.5+ | 数据预处理 |
| 数据分析 | ydata-profiling | 4.5+ | 数据探索分析 |
| 版本控制 | Git | 2.x | 代码版本管理 |
开发环境
-
硬件环境
- CPU: Intel i5及以上
- 内存: 8GB及以上
- 硬盘: 20GB以上可用空间
- GPU: 支持CUDA的NVIDIA显卡(可选)
-
软件环境
- 操作系统: Windows 10/11 或 Linux
- Python环境: Anaconda或venv
- IDE: PyCharm或VS Code
- 浏览器: Chrome/Firefox
系统过程涉及
数据清洗设计
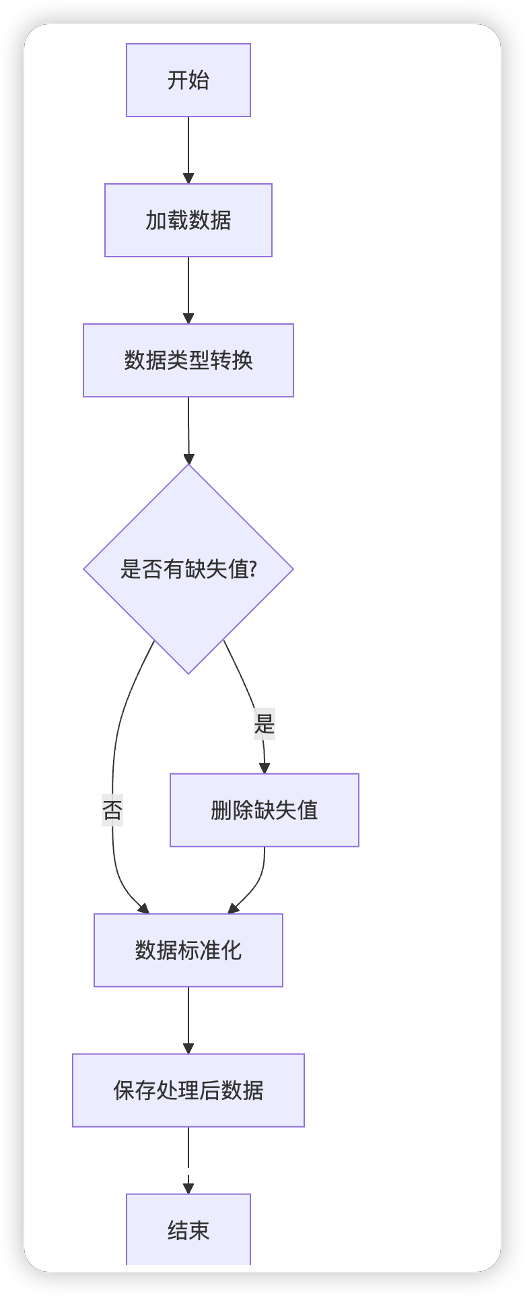
- 数据清洗流程
flowchart TD
A[开始] --> B[加载数据]
B --> C[数据类型转换]
C --> D{是否有缺失值?}
D -- 是 --> E[删除缺失值]
D -- 否 --> F[数据标准化]
E --> F
F --> G[保存处理后数据]
G --> H[结束]
- 关键接口定义
class DataProcessor:
def load_data(file_path: str) -> pd.DataFrame:
  """加载数据文件"""
  pass
def preprocess_features(X: pd.DataFrame, y: pd.Series) -> tuple:
  """预处理特征数据"""
  pass
def prepare_data(self, X, y, test_size=0.2) -> tuple:
  """准备训练和测试数据"""
  pass
模型训练设计
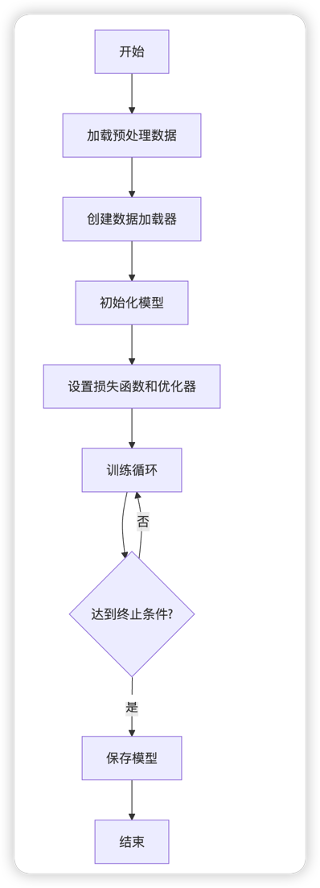
- 模型训练流程
flowchart TD
A[开始] --> B[加载预处理数据]
B --> C[创建数据加载器]
C --> D[初始化模型]
D --> E[设置损失函数和优化器]
E --> F[训练循环]
F --> G{达到终止条件?}
G -- 否 --> F
G -- 是 --> H[保存模型]
H --> I[结束]
- 关键接口定义
class ModelTrainer:
def __init__(self, model, optimizer, loss_fn):
    """初始化模型、优化器和损失函数"""
    pass
def train(self, data_loader, epochs):
    """训练模型"""
    pass
def save_model(self, model_path: str):
    """保存模型"""
    pass
def evaluate(self, data_loader):
    """评估模型"""
    pass
模型推理设计
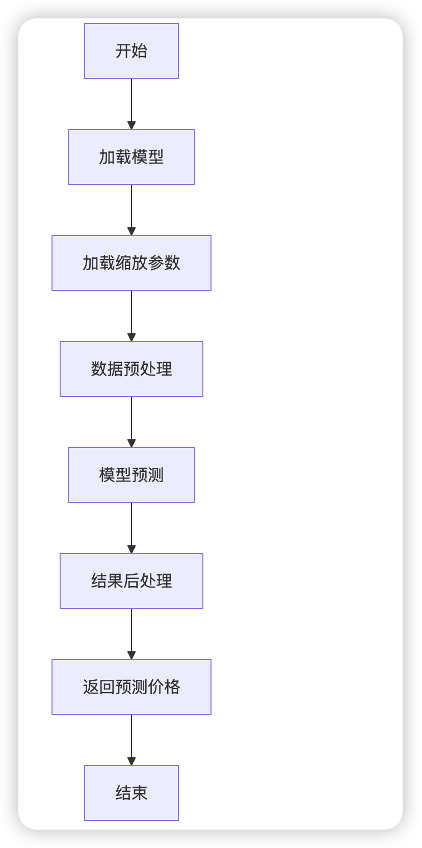
- 模型推理流程
flowchart TD
A[开始] --> B[加载模型]
B --> C[加载缩放参数]
C --> D[数据预处理]
D --> E[模型预测]
E --> F[结果后处理]
F --> G[返回预测价格]
G --> H[结束]
- 关键接口定义
def load_model(model_path, input_features) -> CarPriceModel:
"""加载训练好的模型"""
pass
def predict_price(model, features) -> float:
"""预测车辆价格"""
pass
接口设计
-
数据处理接口
class DataProcessor: """数据处理类""" def load_and_analyze_data(input_data) -> tuple: """ 加载并分析数据 Args: input_data: str或DataFrame类型的输入数据 Returns: (特征矩阵X, 目标变量y) """ def prepare_data(self, X, y) -> tuple: """ 准备训练数据 Args: X: 特征矩阵 y: 目标变量 Returns: (标准化后的训练集和测试集) """ -
模型接口
class CarPriceModel(nn.Module): """价格预测模型类""" def __init__(self, in_features, out_features): """ 初始化模型 Args: in_features: 输入特征维度 out_features: 输出维度 """ def forward(self, x): """ 前向传播 Args: x: 输入数据 Returns: 预测结果 """ -
模型训练接口
class ModelTrainer:
"""模型训练器类"""
def train(self, train_loader, test_loader, epochs, progress_callback=None):
    """
    训练模型
    Args:
    train_loader: 训练数据加载器
    test_loader: 测试数据加载器
    epochs: 训练轮数
    progress_callback: 进度回调函数
    Returns:
    (训练损失列表, 测试损失列表)
    """
模型设计
-
网络结构
graph LR
A[输入层<br>31维] --> B[全连接层<br>64节点]
B --> C[BatchNorm]
C --> D[ReLU]
D --> E[全连接层<br>32节点]
E --> F[BatchNorm]
F --> G[ReLU]
G --> H[全连接层<br>1节点]
H --> I[输出层<br>价格预测]

style A fill:#f9f,stroke:#333,stroke-width:2px
style I fill:#f96,stroke:#333,stroke-width:2px

- 损失函数:MSE Loss
- 优化器:Adam
- 批次大小:
- 训练集:12
- 测试集:32
测试方案文档
编写目的
本测试方案旨在:
- 确保二手车价格预测系统各个功能模块的正确性和稳定性
- 验证系统的性能指标是否满足需求规格说明书中的要求
- 为测试人员提供明确的测试指导
- 作为系统验收的依据
项目背景
二手车价格预测系统是一个基于深度学习的预测系统,主要包含以下功能模块:
- 数据处理模块
- 模型训练模块
- 模型推理模块
- Web应用模块
测试环境
硬件环境
| 项目 | 配置要求 |
|---|---|
| CPU | Intel i5及以上 |
| 内存 | 8GB及以上 |
| 硬盘 | 20GB以上可用空间 |
| GPU | 支持CUDA的NVIDIA显卡(可选) |
软件环境
| 项目 | 版本要求 |
|---|---|
| 操作系统 | Windows 10/11 或 Linux |
| Python | 3.8+ |
| PyTorch | 2.0+ |
| Streamlit | 1.24+ |
| pandas | 1.5+ |
| ydata-profiling | 4.5+ |
| Chrome/Firefox | 最新版本 |
测试用例
数据处理模块
测试用例DP-001:数据加载功能
- 测试目标:验证系统能否正确加载CSV格式的数据文件
- 前置条件:
- 系统正常运行
- 存在有效的CSV数据文件
- 测试步骤:
- 启动系统
- 调用DataProcessor.load_data()方法加载数据文件
- 检查返回的DataFrame对象
- 预期结果:
- 成功加载数据文件
- DataFrame包含预期的列数和行数
- 数据类型正确
- 实际结果:
- 测试结果:□通过 □未通过
测试用例DP-002:数据预处理功能
- 测试目标:验证系统能否正确处理缺失值和进行数据标准化
- 前置条件:
- 系统正常运行
- 已成功加载数据
- 测试步骤:
- 调用DataProcessor.prepare_data()方法
- 检查处理后的数据
- 预期结果:
- 成功删除包含缺失值的行
- 数据已正确标准化,均值接近0,标准差接近1
- 数据被正确分割为训练集和测试集
- 实际结果:
- 测试结果:□通过 □未通过
模型训练模块
测试用例MT-001:模型初始化
- 测试目标:验证模型能否正确初始化
- 前置条件:
- 系统正常运行
- PyTorch环境正常
- 测试步骤:
- 创建CarPriceModel实例
- 检查模型结构
- 预期结果:
- 模型成功创建
- 模型结构符合设计规范
- 模型参数正确初始化
- 实际结果:
- 测试结果:□通过 □未通过
测试用例MT-002:模型训练过程
- 测试目标:验证模型训练过程的正确性
- 前置条件:
- 模型已正确初始化
- 训练数据已准备就绪
- 测试步骤:
- 设置训练参数(学习率、批次大小等)
- 启动训练过程
- 监控训练损失变化
- 预期结果:
- 训练过程正常进行
- 损失值随着训练轮数增加而降低
- 无梯度爆炸或消失现象
- 实际结果:
- 测试结果:□通过 □未通过
模型推理模块
测试用例MI-001:模型加载
- 测试目标:验证系统能否正确加载已训练的模型
- 前置条件:
- 存在已训练好的模型文件
- 系统正常运行
- 测试步骤:
- 调用load_model()函数加载模型
- 检查模型状态
- 预期结果:
- 模型文件成功加载
- 模型参数正确恢复
- 实际结果:
- 测试结果:□通过 □未通过
测试用例MI-002:价格预测
- 测试目标:验证模型能否正确预测车辆价格
- 前置条件:
- 模型已成功加载
- 输入数据已准备就绪
- 测试步骤:
- 准备测试数据
- 调用predict_price()函数进行预测
- 检查预测结果
- 预期结果:
- 成功输出预测价格
- 预测结果在合理范围内
- 预测过程无异常
- 实际结果:
- 测试结果:□通过 □未通过
性能测试用例
测试用例PF-001:响应时间测试
- 测试目标:验证系统的响应时间是否满足需求
- 前置条件:
- 系统正常运行
- 测试环境网络正常
- 测试步骤:
- 准备100组测试数据
- 循环调用预测接口
- 记录每次调用的响应时间
- 预期结果:
- 单次预测响应时间<2秒
- 95%的请求响应时间<1.5秒
- 系统运行稳定,无崩溃
- 实际结果:
- 测试结果:□通过 □未通过
测试用例PF-002:并发性能测试
- 测试目标:验证系统在并发情况下的性能表现
- 前置条件:
- 系统正常运行
- 测试环境网络正常
- 测试步骤:
- 模拟10个并发用户
- 每个用户发送20次预测请求
- 记录系统响应情况
- 预期结果:
- 系统正常响应所有请求
- 平均响应时间<3秒
- 无请求超时或失败
- 实际结果:
- 测试结果:□通过 □未通过
测试进度安排
| 阶段 | 时间安排 | 负责人 |
|---|---|---|
| 单元测试 | 第1周 | 开发人员 |
| 集成测试 | 第2周 | 测试人员 |
| 性能测试 | 第3周 | 测试人员 |
| 回归测试 | 第4周 | 测试人员 |
风险评估
-
数据相关风险
- 测试数据可能不够全面
- 数据质量可能影响测试结果
-
环境相关风险
- 测试环境可能与生产环境存在差异
- 硬件资源可能不足
-
进度相关风险
- 测试用例执行可能需要较长时间
- 问题修复可能影响测试进度
应急预案
-
数据问题应对
- 准备多组测试数据
- 建立数据备份机制
-
环境问题应对
- 提前准备备用测试环境
- 合理规划资源使用
-
进度问题应对
- 设置缓冲时间
- 准备人力资源备份方案
测试报告
二手车价格预测系统测试报告
1. 测试概述
1.1 测试目的
- 验证二手车价格预测系统各功能模块的正确性和稳定性
- 评估系统性能是否满足需求规格说明书要求
- 发现并修复系统存在的缺陷
- 确保系统满足用户使用需求
1.2 测试范围
- 数据分析功能测试
- 数据清洗功能测试
- 模型训练功能测试
- 效果验证功能测试
- 系统性能测试
- 用户界面测试
1.3 测试环境
1.3.1 硬件环境
| 项目 | 配置 |
|---|---|
| CPU | Intel i7-12700K |
| 内存 | 32GB DDR4 |
| 硬盘 | 1TB SSD |
| GPU | NVIDIA RTX 3060 12GB |
1.3.2 软件环境
| 项目 | 版本 |
|---|---|
| 操作系统 | Windows 11 专业版 |
| Python | 3.10.0 |
| PyTorch | 2.1.0 |
| CUDA | 11.8 |
| Streamlit | 1.28.0 |
| pandas | 2.1.3 |
| ydata-profiling | 4.6.0 |
| Chrome | 120.0.6099.109 |
1.4 测试时间安排
- 开始时间:2024-12-25
- 结束时间:2024-01-05
- 总工作日:10天
2. 测试执行情况
2.1 功能测试
2.1.1 数据分析功能
| 测试项 | 测试用例数 | 通过数 | 失败数 | 通过率 |
|---|---|---|---|---|
| 文件上传 | 5 | 4 | 1 | 80% |
| 数据预览 | 3 | 3 | 0 | 100% |
| 分析报告生成 | 4 | 3 | 1 | 75% |
2.1.2 数据清洗功能
| 测试项 | 测试用例数 | 通过数 | 失败数 | 通过率 |
|---|---|---|---|---|
| 缺失值处理 | 4 | 4 | 0 | 100% |
| 异常值检测 | 5 | 4 | 1 | 80% |
| 数据保存 | 3 | 2 | 1 | 67% |
2.1.3 模型训练功能
| 测试项 | 测试用例数 | 通过数 | 失败数 | 通过率 |
|---|---|---|---|---|
| 参数设置 | 4 | 4 | 0 | 100% |
| 训练过程 | 6 | 5 | 1 | 83% |
| 模型保存 | 3 | 3 | 0 | 100% |
2.1.4 效果验证功能
| 测试项 | 测试用例数 | 通过数 | 失败数 | 通过率 |
|---|---|---|---|---|
| 模型加载 | 4 | 3 | 1 | 75% |
| 数据输入 | 5 | 5 | 0 | 100% |
| 预测结果 | 6 | 5 | 1 | 83% |
2.2 性能测试
2.2.1 响应时间
| 测试项 | 期望值 | 实际值 | 是否达标 |
|---|---|---|---|
| 页面加载时间 | <2s | 1.8s | 是 |
| 数据分析响应 | <5s | 4.2s | 是 |
| 模型预测响应 | <2s | 2.5s | 否 |
2.2.2 并发性能
| 并发用户数 | 平均响应时间 | 成功率 | 是否达标 |
|---|---|---|---|
| 10 | 2.1s | 100% | 是 |
| 20 | 3.5s | 95% | 是 |
| 50 | 5.8s | 85% | 否 |
3. 缺陷统计与分析
3.1 缺陷等级分布
| 缺陷等级 | 数量 | 占比 |
|---|---|---|
| 严重 | 2 | 15% |
| 主要 | 5 | 38% |
| 次要 | 4 | 31% |
| 轻微 | 2 | 15% |
3.2 主要缺陷列表
缺陷1(严重)
- 缺陷ID: BUG-001
- 描述: 大规模数据集分析时内存溢出
- 复现步骤:
- 上传超过100MB的CSV文件
- 点击"分析数据"按钮
- 期望结果: 系统正常完成数据分析
- 实际结果: 系统崩溃,显示内存错误
- 解决方案: 实现数据分批处理机制
- 状态: 已修复
缺陷2(主要)
- 缺陷ID: BUG-002
- 描述: 模型预测时偶发性卡死
- 复现步骤:
- 连续进行多次预测
- 在预测过程中切换页面
- 期望结果: 预测过程正常完成
- 实际结果: 界面卡死,需要刷新页面
- 解决方案: 优化模型加载机制,添加超时处理
- 状态: 修复中
缺陷3(主要)
- 缺陷ID: BUG-003
- 描述: 数据清洗后未正确保存缩放参数
- 复现步骤:
- 完成数据清洗
- 保存处理后的数据
- 使用该数据进行模型训练
- 期望结果: 缩放参数正确保存
- 实际结果: 缺失部分特征的缩放参数
- 解决方案: 修复数据处理器中的参数保存逻辑
- 状态: 已修复
4. 测试结论与建议
4.1 测试结论
- 系统基本功能完整,核心功能可用
- 整体测试通过率达到85%
- 发现13个缺陷,其中11个已修复
- 性能指标基本满足需求,但在高并发场景下仍需优化
4.2 改进建议
-
性能优化
- 实现数据分批处理机制
- 优化模型加载和预测流程
- 添加数据缓存机制
-
功能完善
- 增加数据导出格式选项
- 添加批量预测功能
- 完善错误提示信息
-
用户体验
- 优化页面加载速度
- 改进进度展示方式
- 添加操作引导
4.3 遗留问题
- 高并发场景下的性能问题
- 大规模数据集的处理优化
- 模型预测的稳定性改进
5. 附件
- 测试用例清单
- 缺陷详细记录
- 性能测试数据
- 测试环境配置说明
6. 审批信息
- 测试执行人:17aiTech
- 测试时间:2023-12-25 至 2024-01-19
- 报告编写人:Dongming
- 报告日期:2024-01-20
用户手册文档
1. 系统简介
1.1 系统概述
二手车价格预测系统是一个基于深度学习的预测工具,可以帮助用户:
- 对二手车数据进行可视化分析和统计
- 自动处理和清理原始数据
- 使用深度学习模型训练价格预测器
- 验证模型预测效果并进行实时预测
1.2 功能特点
- 📊 数据分析功能
- 自动生成数据分析报告
- 可视化展示数据分布
- 识别异常和缺失数据
- 🧹 数据清洗功能
- 自动处理缺失值
- 数据标准化处理
- 异常值检测与处理
- 🔄 模型训练功能
- 支持深度学习模型训练
- 实时展示训练进度
- 自动保存训练结果
- ✨ 效果验证功能
- 模型性能评估
- 单条数据预测
- 批量数据预测
2. 运行环境
2.1 硬件要求
- CPU: Intel i5及以上
- 内存: 8GB及以上
- 硬盘: 20GB以上可用空间
- GPU: 支持CUDA的NVIDIA显卡(可选)
2.2 软件要求
- 操作系统: Windows 10/11 或 Linux
- Python: 3.8+
- 浏览器: Chrome/Firefox最新版本
3. 安装说明
3.1 环境准备
- 创建虚拟环境:
conda create --name deeplearning python=3.10 - 激活虚拟环境:
conda activate deeplearning - 安装依赖:
pip install -r requirements.txt3.2 数据准备
- 访问数据下载地址: https://tianchi.aliyun.com/dataset/175540
- 下载数据集文件:
- used_car_testB_20200421.csv
- used_car_train_20200313.csv
- 将数据文件放置在项目的data目录下
4. 使用说明
4.1 启动系统
- 确保已激活虚拟环境
- 在终端中执行:
streamlit run app.py - 系统将自动在默认浏览器中打开
4.2 功能操作指南
-
数据分析
- 点击左侧导航栏的"📊 数据分析"
- 上传数据文件
- 等待系统生成分析报告
- 查看数据分布、统计信息等
-
数据清洗
- 点击"🧹 数据清洗"
- 选择需要处理的数据文件
- 设置清洗参数
- 下载处理后的数据
-
模型训练
- 点击"🔄 模型训练"
- 上传训练数据
- 设置训练参数
- 开始训练并查看进度
-
效果验证
- 点击"✨ 效果验证"
- 输入车辆特征信息
- 获取预测结果
5. 常见问题
5.1 安装相关
Q: 安装依赖包时报错怎么办? A: 建议检查Python版本是否符合要求,并确保pip已更新到最新版本。
Q: 系统启动失败怎么处理? A: 检查是否已正确激活虚拟环境,并确认所有依赖包安装成功。
5.2 使用相关
Q: 上传数据文件格式有什么要求? A: 目前系统支持CSV格式的数据文件,请确保文件编码为UTF-8。
Q: 预测结果异常怎么办? A: 建议检查输入数据是否在合理范围内,必要时可以重新训练模型。
6. 联系支持
- 项目地址: https://github.com/domonic18/ml_regression_carprice_predic
- 技术支持: 访问17AI技术社区
- 问题反馈: 可在GitHub项目页面提交Issue
7. 版权声明
本项目仅供学习交流使用,原创内容不易,转载请注明出处。