【模型测试】大模型评测工具lm-evaluation-harness的使用方法总结
前言
在大模型的测评中,我们往往需要借助一些自动化工具来完成测评任务,本章将介绍常见的自动化测评工具:lm-evaluation-harness。
工具简介
lm-evaluation-harness 是由 EleutherAI 开发的开源工具,用于统一评估语言模型(如 GPT、LLaMA 等)在多样化任务中的性能。支持 200+ 评测任务,涵盖文本生成、逻辑推理、数学计算等领域。
工具使用
1. 工具下载
git clone https://github.com/EleutherAI/lm-evaluation-harness.git2. 安装工具
2.1 创建虚拟环境
安装依赖之前,最好通过conda创建一个虚拟环境,然后进入虚拟环境安装依赖。
conda create -n lm_eval python=3.10
conda activate lm_eval
2.2 安装工具
进入虚拟环境后,安装工具。
cd lm-evaluation-harness
pip install -e .
2.3 安装依赖
# 安装sentencepiece
pip install torch sentencepiece protobuf
# 安装torch
pip install torch torchvision torchaudio2.4 测试安装
正常安装之后,可以使用命令lm_eval -h测试是否成功。
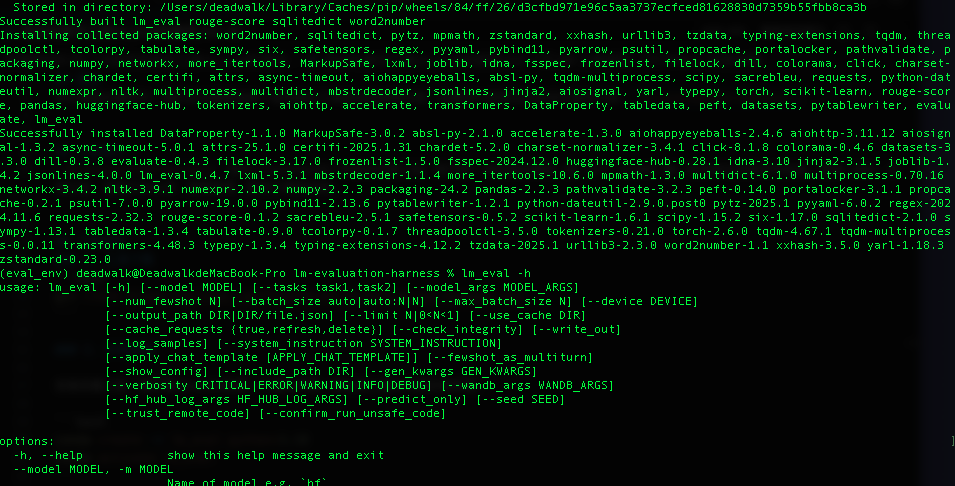
通过lm_eval -h命令可以看到,lm_eval可以连接Hugging Face的模型,也可以连接本地模型进行评测。由于国内对Hugging Face的访问受限,所以这里选择连接本地模型。
3. 模型下载
本次测试中,我们使用最近火热的deepseek在Qwen上的蒸馏版本 deepseek-ai/DeepSeek-R1-Distill-Qwen-7B。
第一步:访问modelscope,搜索deepseek模型。
第二步:在搜索的 DeepSeek-R1-Distill-Qwen-7B 模型中,获取下载地址。
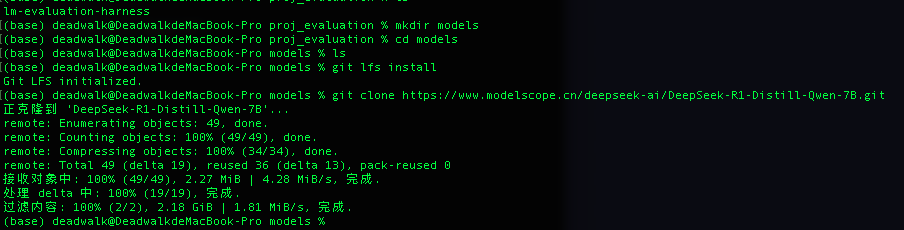
第三步:使用git lfs下载模型。
# 进入lm_eval目录
cd lm_evaluation_harness

# 创建models目录
mkdir models

# 进入models目录
cd models

# 安装git lfs
git lfs install

# 下载模型
git clone https://www.modelscope.cn/deepseek-ai/DeepSeek-R1-Distill-Qwen-7B.git
运行结果:
4. 下载评测数据集
由于国内Hugging Face访问受限,直接通过lm_eval的命令默认会请求huggingface hub,导致下载数据集异常,报错TypeError: 'NoneType' object is not callable。
所以,我们需要手动下载数据集。
# 切换至lm_eval目录
cd lm_evaluation_harness

# 创建数据集目录
mkdir -p datasets/hellaswag

# 进入数据集目录
cd datasets/hellaswag

# 下载 hellaswag 数据集
git clone https://github.com/rowanz/hellaswag.git

# 将 hellaswag 数据集复制到数据集目录
cd hellaswag
cp -r hellaswag/data/* ./
确保拷贝后的文件组成为:
lm_evalution_harness
├──datasets
│   ├──hellaswag
│   │   ├──hellaswag_test.jsonl
│   │   ├──hellaswag_train.jsonl
│   │   ├──hellaswag_val.jsonl
5. 配置数据集
# 切换至lm_eval目录
cd lm_evaluation_harness

# 进入task目录
cd lm_eval/tasks/hellaswag

# 编辑.yaml文件
vim hellaswag.yaml
将.yaml文件中的dataset_path修改为 4.下载评测数据集 中的地址。
tag:
  - multiple_choice
task: hellaswag
dataset_path: /root/autodl-tmp/lm-evaluation-harness/datasets/hellaswag
dataset_name: null
output_type: multiple_choice
training_split: train
validation_split: validation
test_split: null
process_docs: !function utils.process_docs
doc_to_text: "{{query}}"
doc_to_target: "{{label}}"
doc_to_choice: "choices"
metric_list:
  - metric: acc
    aggregation: mean
    higher_is_better: true
  - metric: acc_norm
    aggregation: mean
    higher_is_better: true
metadata:
  version: 1.0
dataset_kwargs:
  trust_remote_code: true
6. 评测执行
确保修改后的文件路径为:
目录结构
lm-evaluation-harness
├──models                   # 保存下载好的模型
├──datasets                 # 保存下载好的数据集
│   ├──hellaswag
├──results                  # 保存评测结果
├──tasks                    # 保存评测任务
├──utils                    # 保存工具函数
├──lm_eval.py               # 评测主程序
├──requirements.txt         # 依赖库
├──README.md                # 说明文档
├──LICENSE
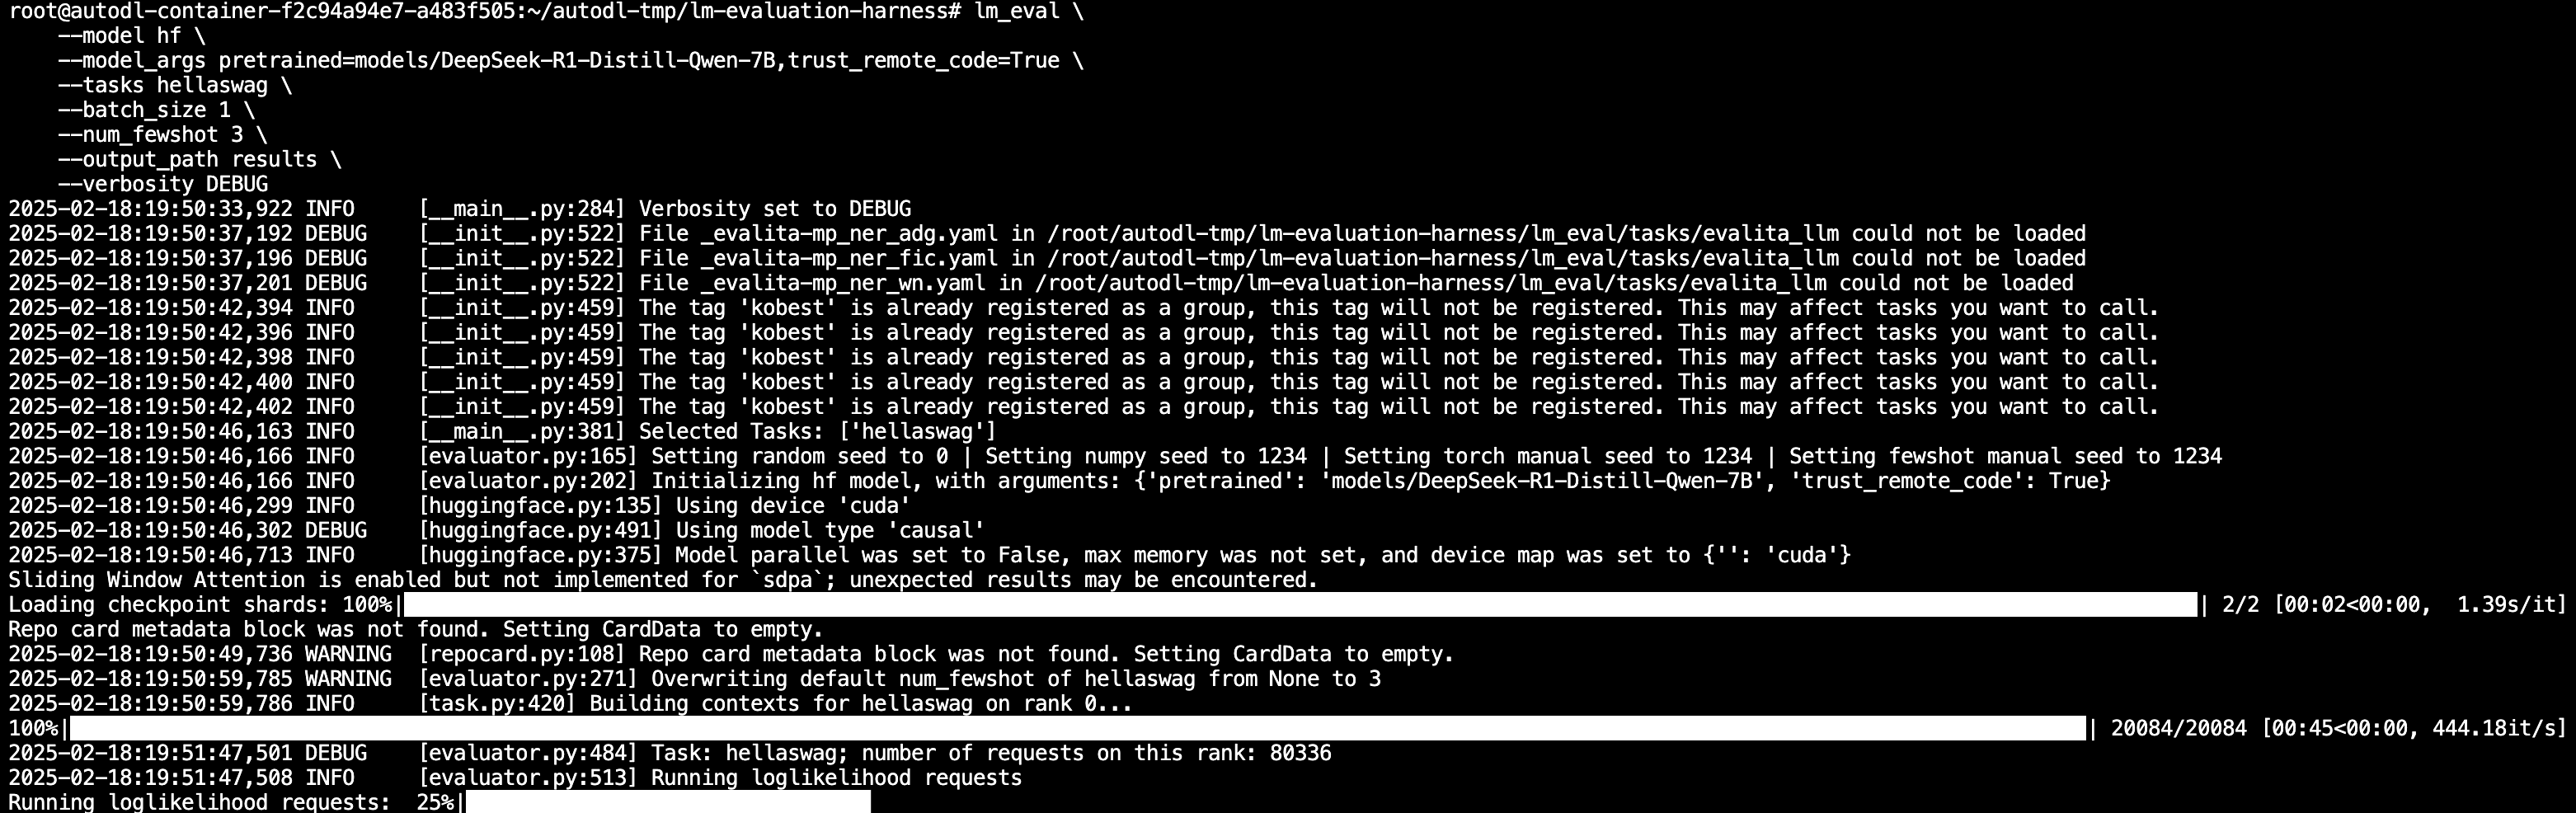
在 lm-evaluation-harness 根目录下,执行评测命令
lm_eval \
    --model hf \
    --model_args pretrained=models/Qwen2.5-7B-Instruct,trust_remote_code=True \
    --tasks hellaswag \
    --batch_size 1 \
    --num_fewshot 3 \
    --output_path ./results.json \
    --verbosity DEBUG
测试中:
测试完毕:

补充说明:
Tasks:评估的任务名称,此处为HellaSwagVersion:数据集的版本号,此处为1。Filter:数据预处理方式,none表示未对数据额外过滤。n-shot:Few-shot学习中的示例数量,此处为3(每个测试样本提供3个上下文示例)。Metric:评估指标:
acc:原始准确率(未经调整)。acc_norm:标准化后的准确率(可能调整了选项长度等偏差,更可靠)。Value:模型在该指标下的得分,↑表示值越高越好。Stderr:标准误差(衡量结果波动范围,±后为误差值)。
由上可知:
-
原始准确率(acc):46.47% ± 0.35%
模型直接预测的准确率,可能存在数据集本身的偏差(如选项长度差异)。
-
标准化准确率(acc_norm):60.92% ± 0.34%
经过标准化处理的准确率(HellaSwag常用指标),更客观反映模型性能。
参考文献
CSDN:LLMs之benchmark之lm-evaluation-harness
其他文章
- 【模型测试】大模型测评体系的构成
- 【模型测试】大模型评测工具lm-evaluation-harness的使用方法总结
- 【模型测试】大模型评测工具OpenCompass使用方法总结
- 【模型测试】ai-eval-system在线评测系统v0.2预览版本介绍
欢迎关注公众号以获得最新的文章和新闻