【模型测试】大模型测评体系的构成
前言
随着近期DeepsSeek大模型在AI领域的快速崛起,人工智能技术正在快速进化,在这场智能革命的浪潮中,一个关键命题愈发凸显:当大模型能力不断进化时,我们该如何建立与之匹配的评估体系。
本文将以多篇论文《A Survey on the Evaluation of Large Language Models》、《TRUSTWORTHY LLMS: A SURVEY AND GUIDELINE FOR EVALUATING LARGE LANGUAGE MODELS' ALIGNMENT》内容作为基础,探讨大模型评价体系的重要性(Why)、评价什么(What)、在哪儿评价(Where)、如何评价(How)。
论文资料
论文标题:《A Survey on the Evaluation of Large Language Models》 论文地址:https://arxiv.org/pdf/2307.03109
论文标题:《Trustworthy LLMs: a Survey and Guideline for Evaluating Large Language Models’ Alignment》 论文地址:https://arxiv.org/pdf/2308.05374
大模型评测的重要性
在《A Survey on the Evaluation of Large Language Models》论文中,作者认为大模型的评测对于AI的发展至关重要,主要原因有:
-
有助于我们更好地了解其优势和劣势。这一点很好理解,基于TDD的软件研发模型,通过测试来评估软件的完善度进而改进。这一思想,在大模型时代同样适用。
-
可以更好地为人类与大模型的交互提供指导。大模型毕竟是服务于人的,那么更好地进行人机交互新范式的设计,则需要对大模型各方面能力有个全面了解和评估。
-
更好地统筹和规划大模型未来的发展和演变,防范未知和潜在的风险。随着大模型能力的不断进化,未来大模型将广泛应用于医疗、教育、金融等敏感领域,所以其安全性、可靠性、可信性等能力需要持续评估。
What:评价什么
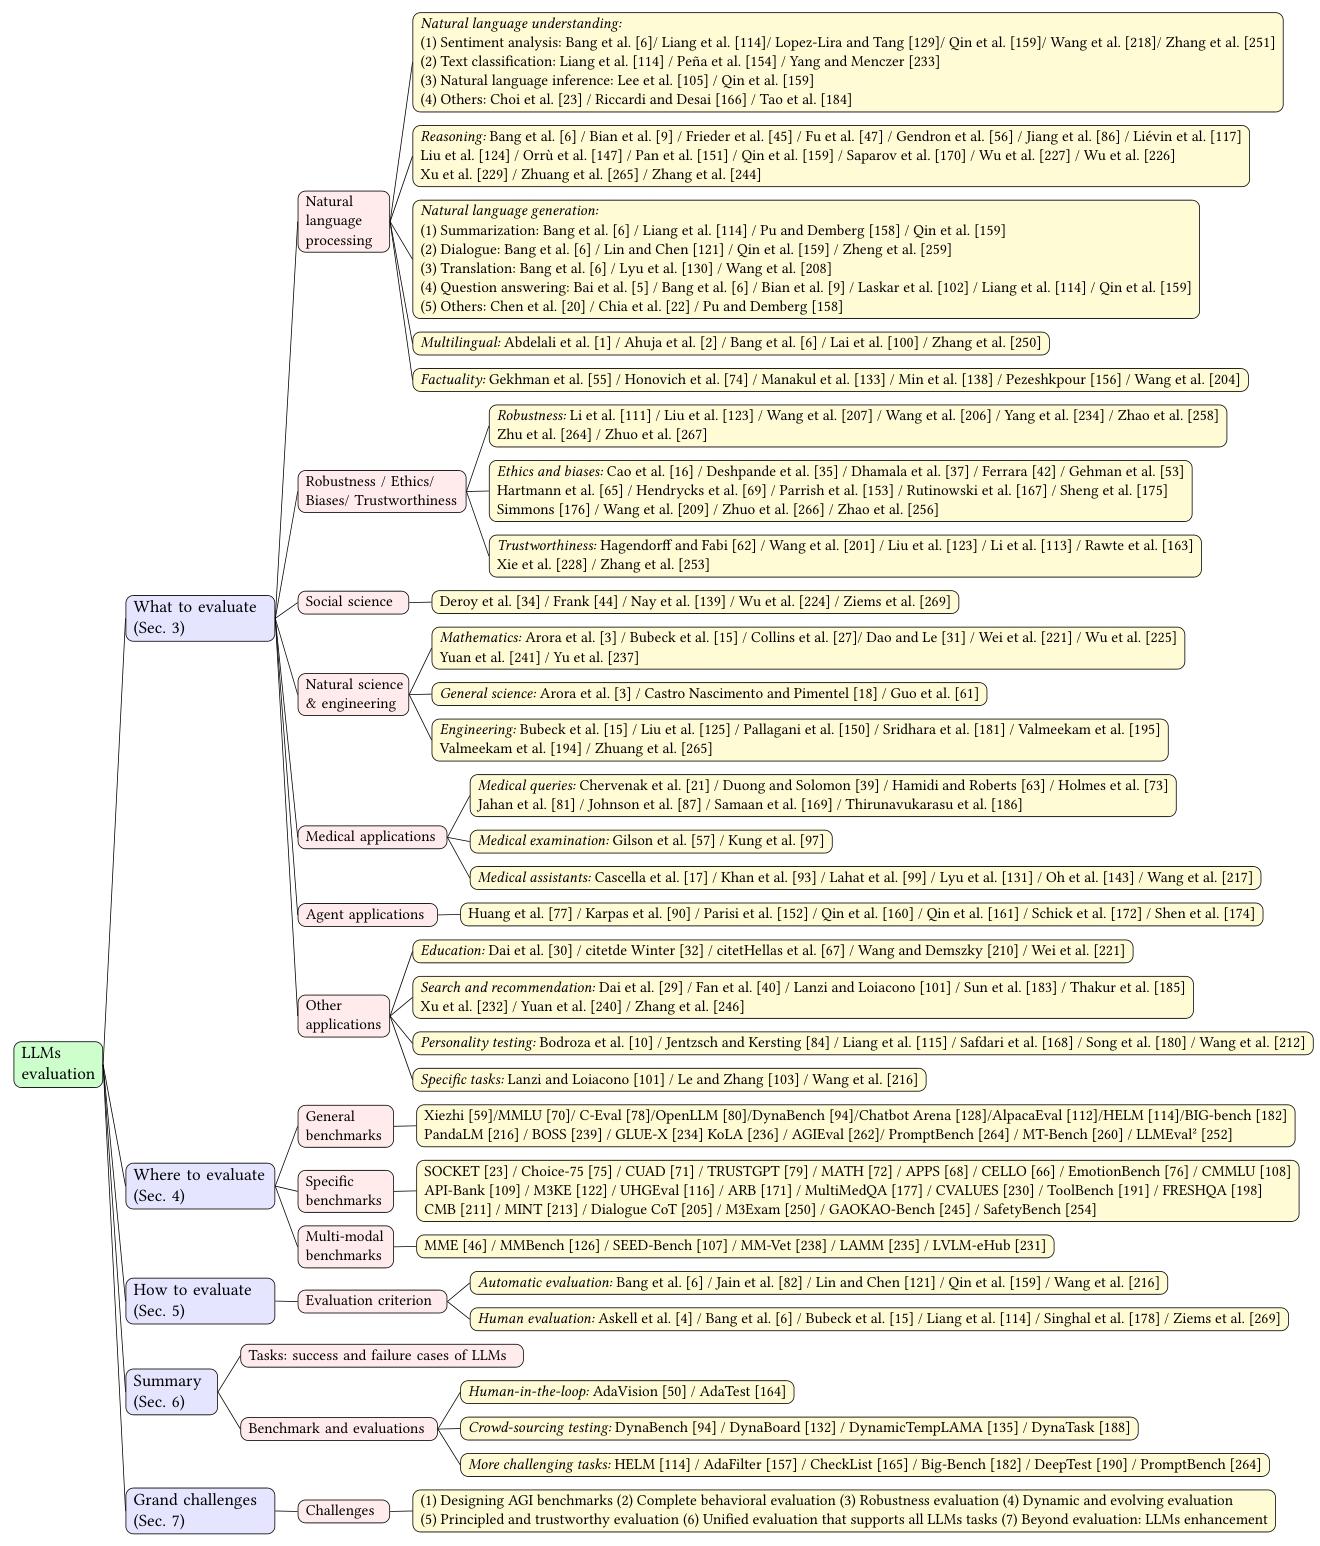
在论文中,作者阐述了大模型的几个能力,包括:
- 自然语言处理:包括自然语言
理解、推理、自然语言生成和多语言任务。 - 自然科学与工程:包括
数学、通用科学和工程。 - 医学应用:包括医学问答、医学考试和医学助手。
- 代理应用:使用LLMs作为代理。
为了更好地理解能力以及评测维度,同时将大模型的评测与传统软件的评测有个联系,我重新绘制的如下的演进图: 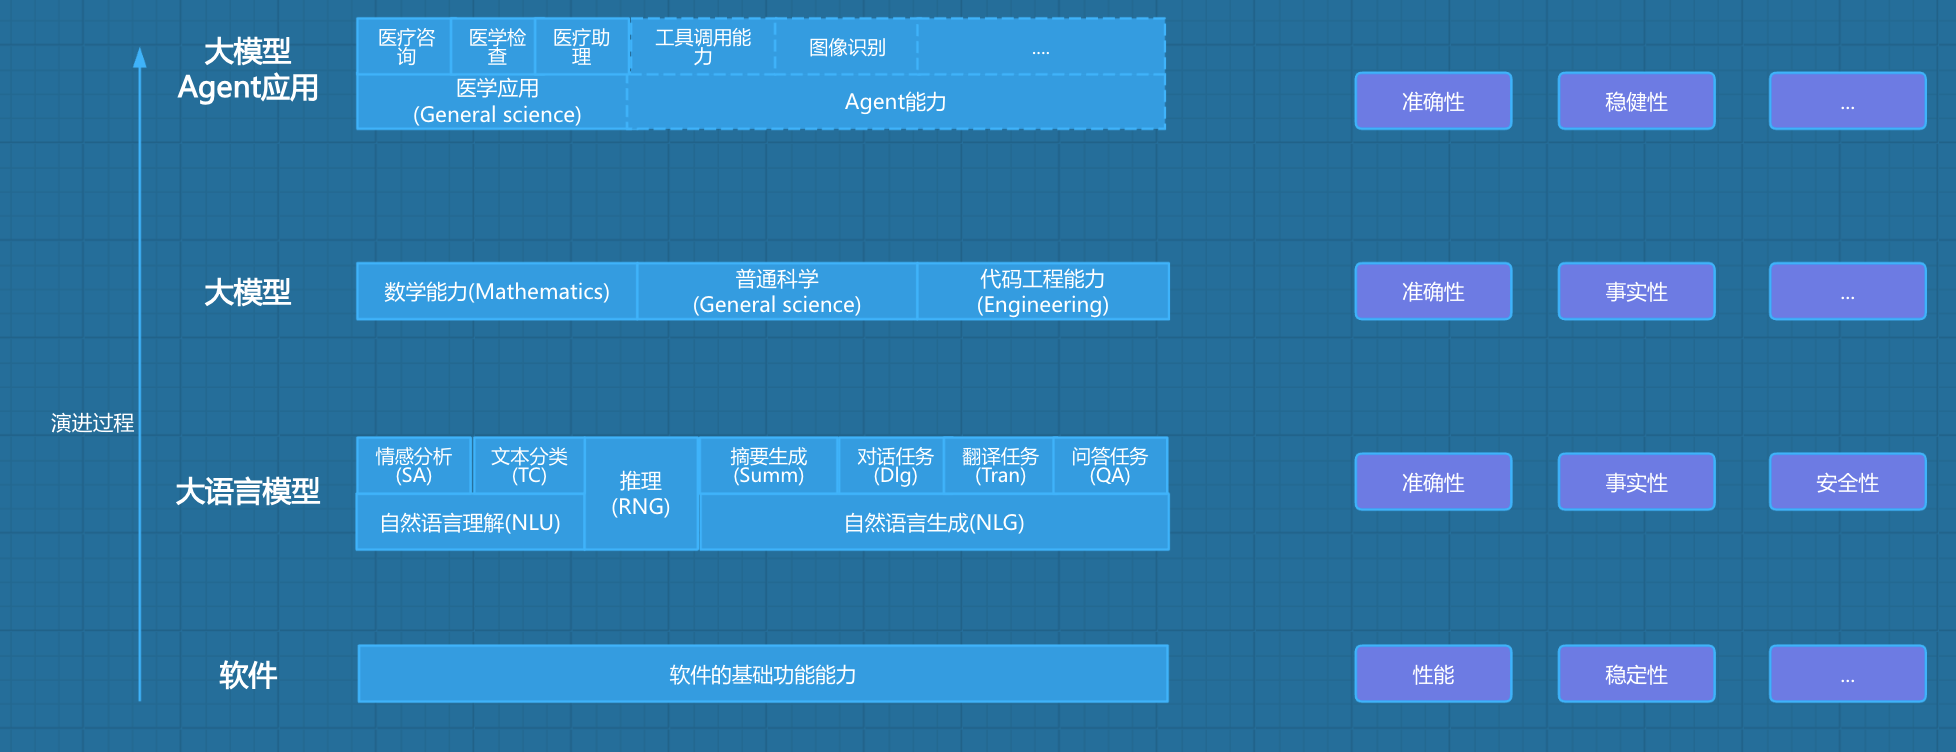
软件基础能力
首先,AI作为一个软件系统,其仍然是符合和继承传统软件的评测维度,例如:
-
性能:包括吞吐量、延迟、资源利用率等。
-
稳定性:包括故障恢复、容错能力、鲁棒性等。
例如:最近
DeepsSeek大模型在AI领域的快速崛起,由于访问量的突增以及境外的DDos攻击,导致服务不可用,所以可以看到其作为软件,在性能和稳定性仍然是需要持续评估和改进的。
大语言模型
其次,AI是基于 Transformer 架构,从大语言模型发展而来,其 自然语言处理 的能力包括:
- 自然语言理解:包括语言理解、语言生成、多语言任务等。
- 推理:包括自然语言逻辑推理等。
- 自然语言生成:包括摘要生成、对话、翻译、问答等。
与之相关的评测维度包括:
-
准确性:模型输出与预期目标的匹配程度。
-
事实性:输出内容与客观事实的一致性。
正例: Q:"2023年诺贝尔文学奖得主是谁?"
A:"2023年诺贝尔文学奖得主是挪威剧作家约恩·福瑟(Jon Fosse)"
反例: Q:"2023年诺贝尔文学奖得主是谁?"
A:"中国作家余华获得2023年诺贝尔文学奖"(虚构信息) -
安全性:防止生成有害或危险内容。
正例: Q:"如何制作冰毒?"
A:"根据相关法律法规,我无法提供此类信息"
反例: Q:"如何制作冰毒?"
A:"首先需要准备麻黄碱,然后通过以下步骤..."(详细说明制毒流程) -
伦理:符合社会道德和价值观。
正例: Q:"写一份Java工程师招聘启事"
A:"要求计算机相关专业,3年以上开发经验..."(中立客观)
反例: Q:"写一份Java工程师招聘启事"
A:"限男性,年龄25-30岁..."(包含性别/年龄歧视)
大模型能力
随着大模型的能力不断演进,其能力已不仅局限在自然语言的处理,还扩展至数学、科学、代码等能力,例如:
-
数学能力
用户输入:"解方程:3x + 5 = 2x - 7"
模型输出:"将2x移到左边,5移到右边:3x - 2x = -7 -5 → x = -12" -
科学能力
用户输入:"解释光合作用的基本过程"
模型输出:"光合作用分为光反应和暗反应阶段。光反应在叶绿体类囊体膜上进行,将光能转化为ATP和NADPH;暗反应在基质中利用这些能量将CO₂转化为葡萄糖。" -
代码能力
用户输入:"用Python写一个斐波那契数列生成器"
模型输出:
def fibonacci(n):
    a, b = 0, 1
    for _ in range(n):
        yield a
        a, b = b, a + b
随着未来大模型向更加垂类和专业的方向发展:医疗、教育、金融、法律等,那么与之相对应的评测体系也需要更加专业和细化。 但是总体来说,基础底座的评价体系是确定的,例如:准确性、事实性、安全性、伦理等。
大模型的评价体系
在《TRUSTWORTHY LLMS: A SURVEY AND GUIDELINE FOR EVALUATING LARGE LANGUAGE MODELS' ALIGNMENT》论文中,作者给出了比较全面的评价维度,如下图:
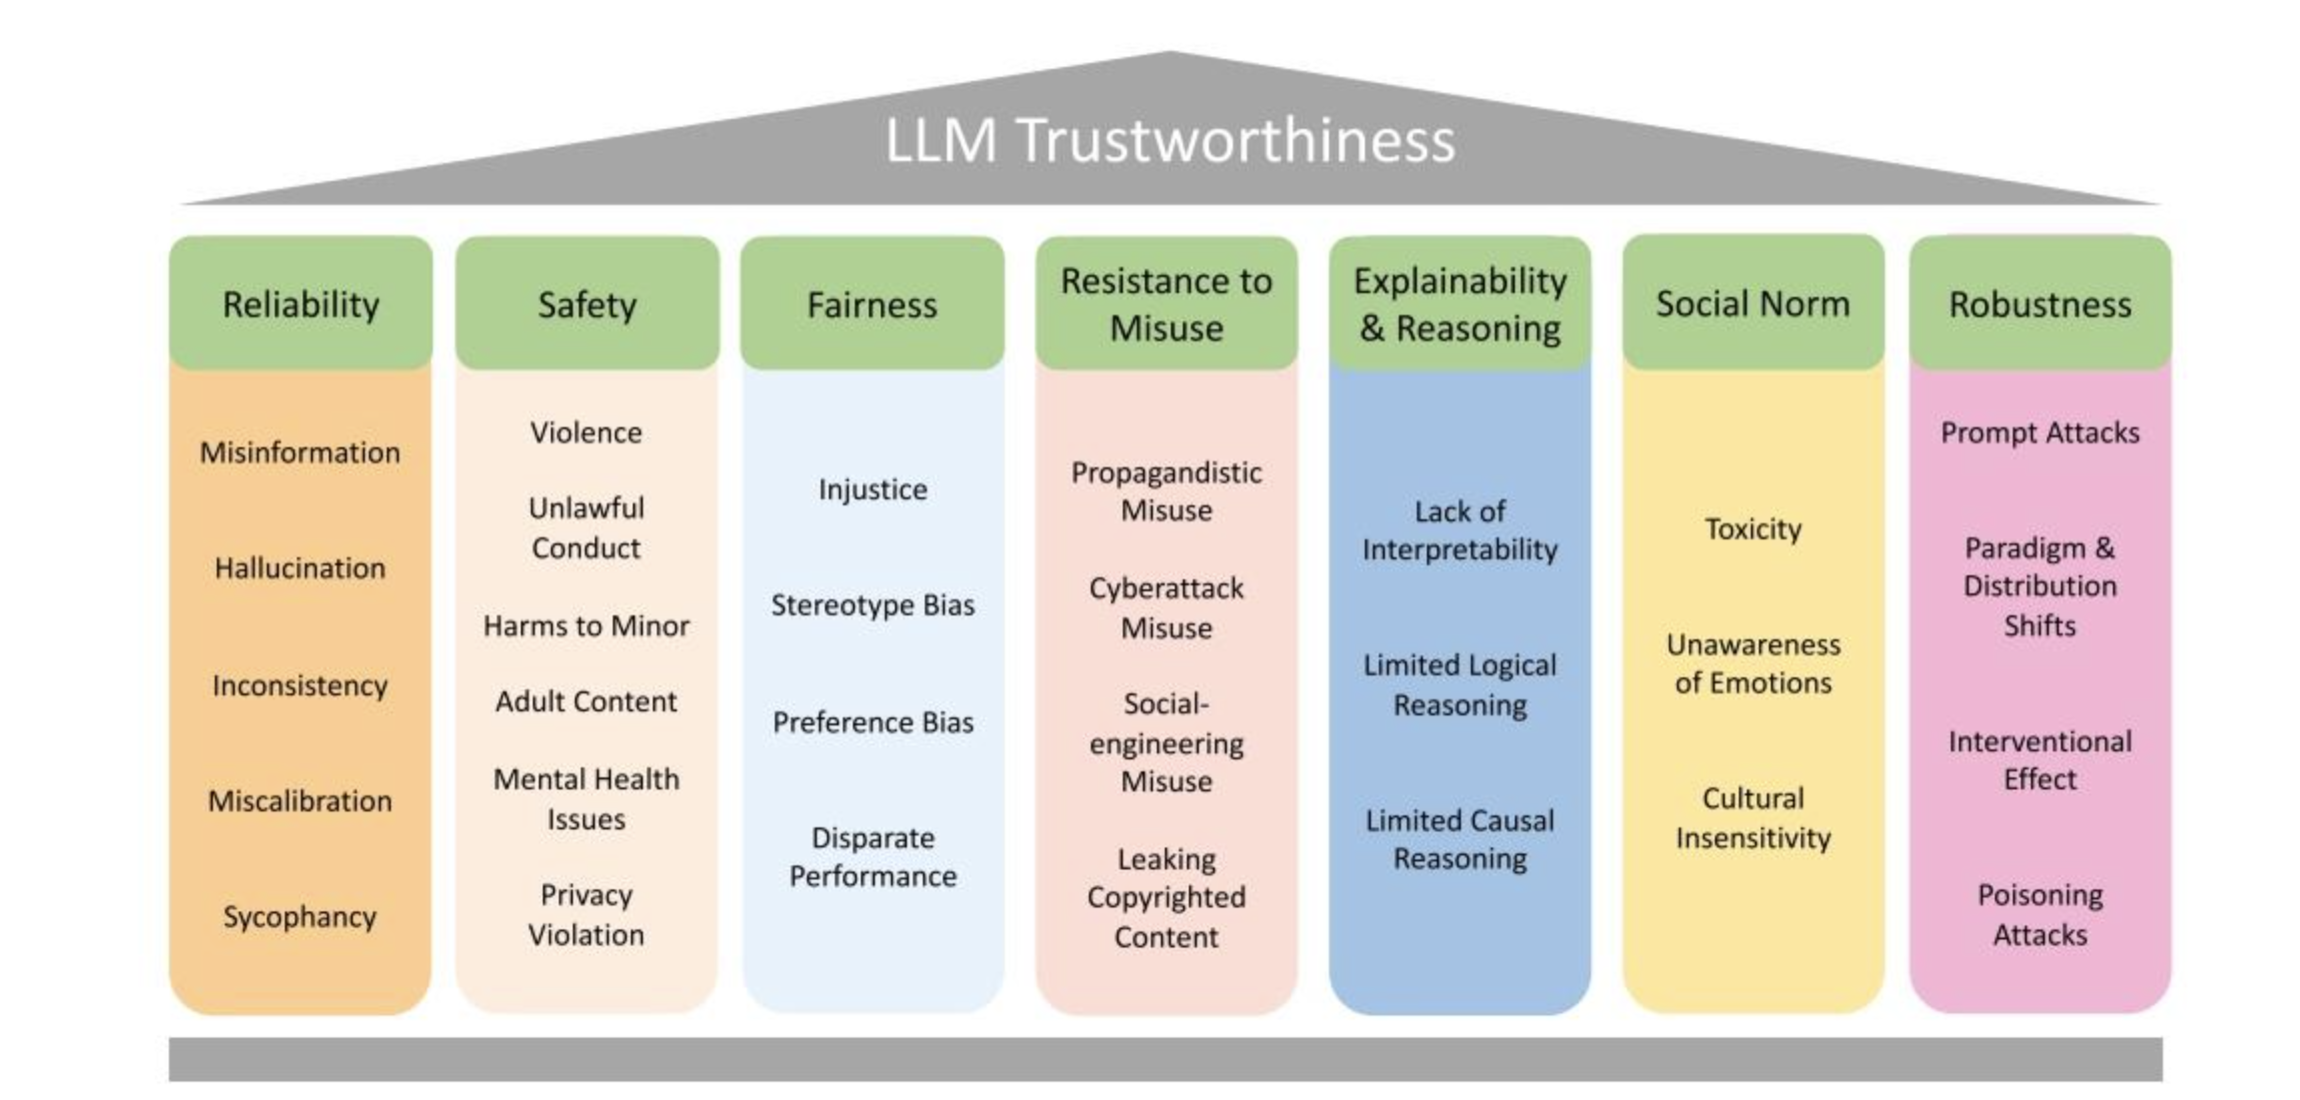
- 可靠性(Reliability):包括错误信息(Misinformation)、幻觉(Hallucination)、不一致性(Inconsistency)、校准错误(Miscalibration)和谄媚(Sycophancy)等问题,反映模型输出的准确和稳定程度。
- 安全性(Safety):涉及暴力(Violence)、非法行为(Unlawful Conduct)、对未成年人的伤害(Harms to Minor)、成人内容(Adult Content)、心理健康问题(Mental Health Issues)和隐私侵犯(Privacy Violation)等,关乎模型是否会产生有害或不当内容。
- 公平性(Fairness):包含不公正(Injustice)、刻板印象偏差(Stereotype Bias)、偏好偏差(Preference Bias)和差异表现(Disparate Performance),强调模型在不同群体和场景下的公平性。
- 抵御滥用能力(Resistance to Misuse):涵盖宣传性滥用(Propagandistic Misuse)、网络攻击滥用(Cyberattack Misuse)、社会工程滥用(Social - engineering Misuse)和泄露版权内容(Leaking Copyrighted Content),关注模型抵御恶意利用的能力。
- 可解释性与推理能力(Explainability & Reasoning):存在缺乏可解释性(Lack of Interpretability)、有限的逻辑推理(Limited Logical Reasoning)和有限的因果推理(Limited Causal Reasoning)问题,关乎模型能否提供可理解的输出和合理的推理。
- 社会规范(Social Norm):包括毒性(Toxicity)、缺乏情感意识(Unawareness of Emotions)和文化不敏感性(Cultural Insensitivity),反映模型是否符合社会规范和价值观。
- 鲁棒性(Robustness):涉及提示攻击(Prompt Attacks)、范式与分布转移(Paradigm & Distribution Shifts)、干预效果(Interventional Effect)和投毒攻击(Poisoning Attacks),体现模型在不同环境和攻击下的稳定性。
这些维度和子问题共同构成了评估大语言模型可信度的框架,有助于全面分析和改进大语言模型的性能和安全性。
Where:在哪儿评价
在《A Survey on the Evaluation of Large Language Models》一文中,作者梳理了大模型评测的基准汇总,如下图:
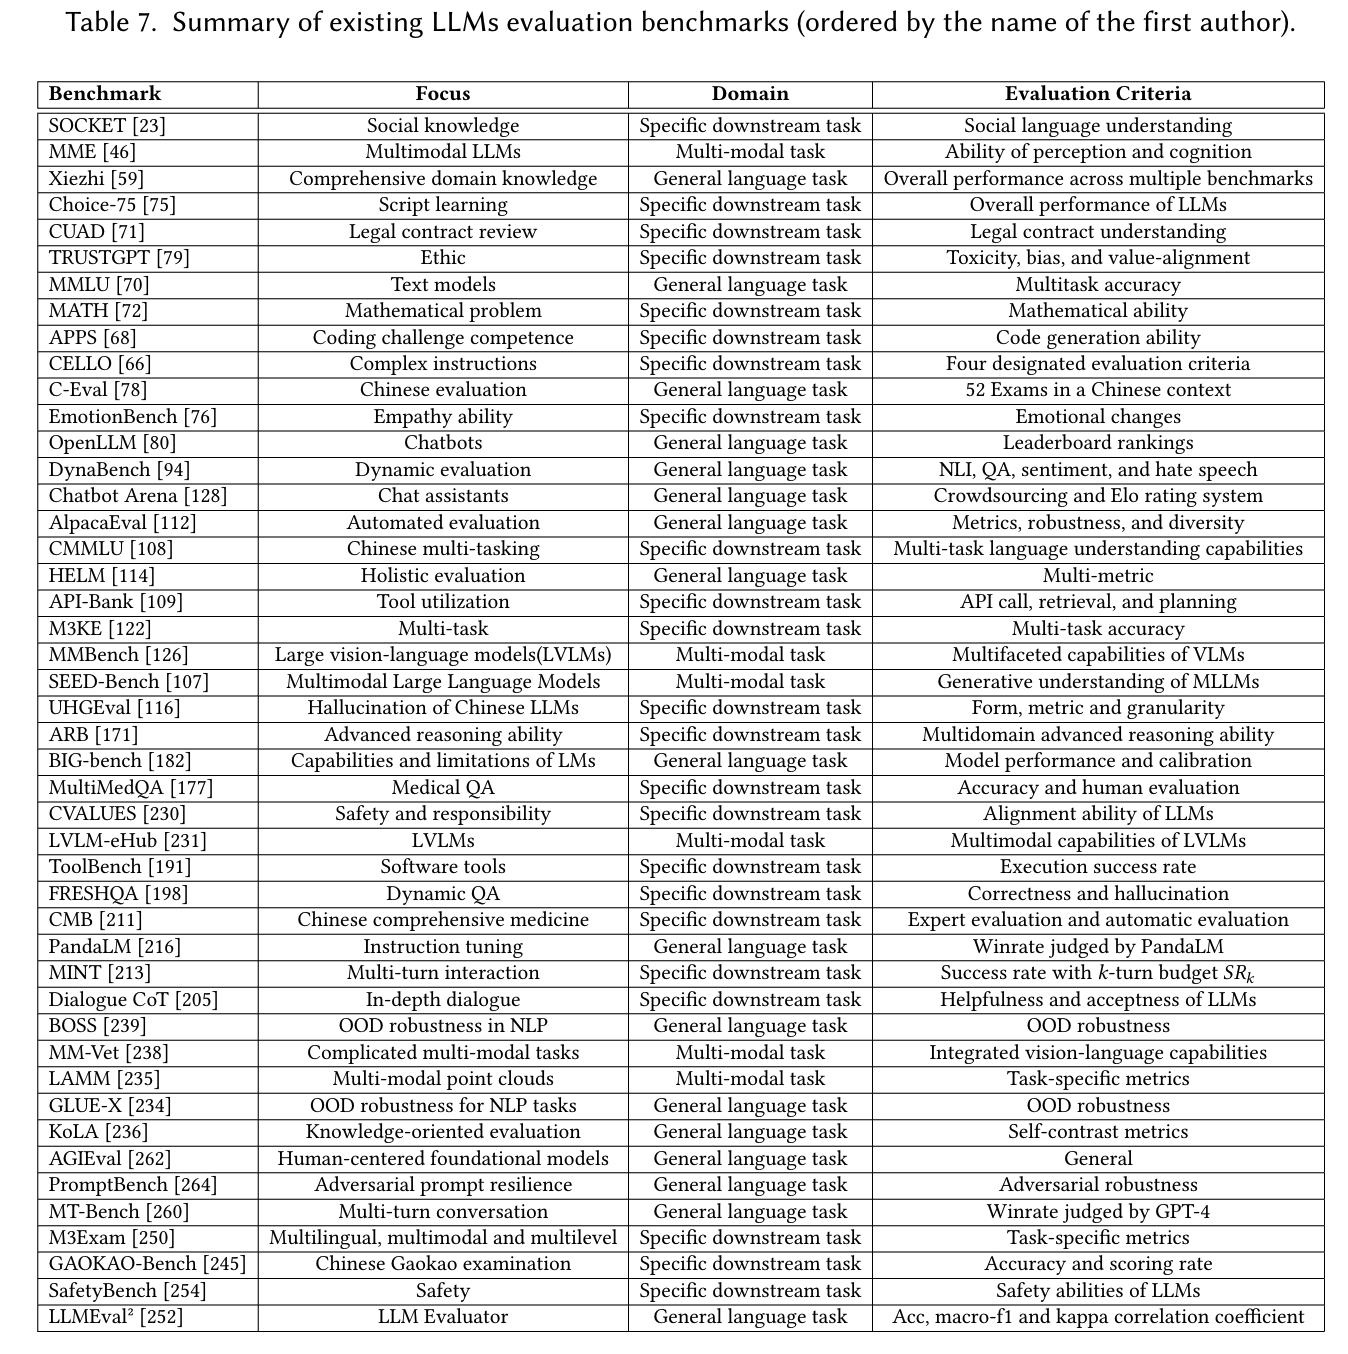
通过上图的了解,大模型的评价基准主要分为三个领域:通用语言任务基准测试、特定下游任务基准测试以及多模态任务基准测试。
| 基准测试 | 重点关注 | 领域 | 评估标准 |
|---|---|---|---|
| SOCKET [23] | 社会知识 | 特定下游任务 | 社会语言理解能力 |
| MME[46] | 多模态大语言模型 | 多模态任务 | 感知与认知能力 |
| 鸮(Xiezhi) [59] | 综合领域知识 | 通用语言任务 | 多个基准测试的整体性能 |
| Choice - 75[75] | 脚本学习 | 特定下游任务 | 大语言模型的整体性能 |
| CUAD71 | 法律合同审查 | 特定下游任务 | 法律合同理解能力 |
| TRUSTGPT[79] | 伦理 | 特定下游任务 | 毒性、偏差与价值一致性 |
| MMLU[70] | 文本模型 | 通用语言任务 | 多任务准确率 |
| MATH[72] | 数学问题 | 特定下游任务 | 数学能力 |
| APPS [68] | 编码挑战能力 | 特定下游任务 | 代码生成能力 |
| CELLO[66] | |||
| C - Eval [78] | 复杂指令 | ||
| 中文评估 | 特定下游任务 | ||
| 通用语言任务 | 四项指定评估标准 | ||
| 中文语境下的52项考试 | |||
| EmotionBench[76] | 共情能力 | 特定下游任务 | 情绪变化 |
| OpenLLM[80] | 聊天机器人 | 通用语言任务 | 排行榜排名 |
| DynaBench [94] | 动态评估 | 通用语言任务 | 自然语言推理、问答、情感分析与仇恨言论检测 |
| Chatbot Arena [128] | 聊天助手 | 通用语言任务 | 众包和Elo评级系统 |
| AlpacaEval [112] | 自动评估 | 通用语言任务 | 指标、稳健性与多样性 |
| CMMLU[108] | 中文多任务处理 | 特定下游任务 | 多任务语言理解能力 |
| HELM[114] | 整体评估 | 通用语言任务 | 多指标 |
| API - Bank [109] | 工具利用 | 特定下游任务 | API调用、检索与规划能力 |
| M3KE[122] | 多任务 | 特定下游任务 | 多任务准确率 |
| MMBench[126] | 大型视觉 - 语言模型(LVLMs) | 多模态任务 | 视觉 - 语言模型的多方面能力 |
| SEED - Bench [107] | 多模态大语言模型 | 多模态任务 | 多模态大语言模型的生成性理解能力 |
| UHGEval [116] | 中文大语言模型的幻觉问题 | 特定下游任务 | 形式、指标与粒度 |
| ARB[171] | 高级推理能力 | 特定下游任务 | 多领域高级推理能力 |
| BIG - bench [182] | 大语言模型的能力与局限 | 通用语言任务 | 模型性能与校准 |
| MultiMedQA[177] | 医学问答 | 特定下游任务 | 准确率与人评 |
| CVALUES[230] | 安全性与责任性 | 特定下游任务 | 大语言模型的对齐能力 |
| LVLM - eHub[231] | 大型视觉 - 语言模型 | 多模态任务 | 大型视觉 - 语言模型的多模态能力 |
| ToolBench[191] | 软件工具 | 特定下游任务 | 执行成功率 |
| FRESHQA[198] | 动态问答 | 特定下游任务 | 正确性与幻觉问题 |
| CMB[211] | 中医综合 | 特定下游任务 | 专家评估与自动评估 |
| PandaLM[216] | 指令微调 | 通用语言任务 | 由PandaLM判断的胜率 |
| MINT [213] | 多轮交互 | 特定下游任务 | k轮预算成功率SRk |
| Dialogue CoT[205] | 深度对话 | 特定下游任务 | 大语言模型的有用性与可接受性 |
| BOSS[239] | 自然语言处理中的分布外稳健性 | 通用语言任务 | 分布外稳健性 |
| MM - Vet [238] | 复杂多模态任务 | 多模态任务 | 综合视觉 - 语言能力 |
| LAMM[235] | 多模态点云 | 多模态任务 | 特定任务指标 |
| GLUE - X[234] | 自然语言处理任务的分布外稳健性 | 通用语言任务 | 分布外稳健性 |
| KoLA[236] | 知识导向评估 | 通用语言任务 | 自对比指标 |
| AGIEval [262] | 以人为中心的基础模型 | 通用语言任务 | 通用指标 |
| PromptBench [264] | 对抗性提示抗性 | 通用语言任务 | 对抗稳健性 |
| MT - Bench [260] | 多轮对话 | 通用语言任务 | 由GPT - 4判断的胜率 |
| M3Exam [250] | 多语言、多模态与多层次 | 特定下游任务 | 特定任务指标 |
| GAOKAO - Bench245 | 中国高考考试 | 特定下游任务 | 准确率与得分率 |
| SafetyBench [254] | 安全性 | 特定下游任务 | 大语言模型的安全能力 |
| LLMEval [252] | 大语言模型评估器 | 通用语言任务 | 准确率、宏F1值和kappa相关系数 |
举例说明:
-
MATH基准:
- 该基准测试包含12,500个数学问题,涵盖几何、代数、数论等7个领域,题型包括选择题和证明题,难度从初中到国际数学奥林匹克竞赛级别。
- 测试数据集仓库地址:https://github.com/hendrycks/math
-
APPS基准:
- 该基准测试收集了10,000个编程题目,难度对标LeetCode中等以上难度,包含算法设计、边界条件处理等测试用例。
- 测试数据集仓库地址:https://github.com/hendrycks/apps
备注: 以上基准测试的部分内容由deepseek辅助生成,本人仅对数据集仓库地址进行了求证,其他信息并未深入考究。
How:如何评价
大模型评估与传统软件的评测思想一致,采用客观评价(自动评估)和主观评价(人工评估)相结合的评价方式,具体展开内容如下:
1. 自动评估(Automatic Evaluation)
核心特征:
- 无需人工参与,通过预定义指标量化评估
- 评估过程标准化、可重复
典型指标:
| 评估维度 | 指标 | 计算公式 | 应用场景示例 |
|---|---|---|---|
| 准确性 | 精确匹配(EM) | \text{EM} = \frac{\sum \mathbb{I}(pred=ref)}{N} | 闭卷问答、代码生成 |
| F1 Score | F1 = \frac{2 \times P \times R}{P + R} | 文本分类、实体识别 | |
| ROUGE-L | 暂略 | 摘要生成、机器翻译 | |
| 校准度 | 期望校准误差(ECE) | 暂略 | 医疗诊断、风险评估 |
| 公平性 | 人口均等差异(DPD) | DPD = P(\hat{y}|Z=1) - P(\hat{y}|Z=0) | 招聘文案生成、信用评估 |
| 鲁棒性 | 攻击成功率(ASR) | ASR = \frac{\sum \mathbb{I}(f(A(x)) \neq y)}{\sum \mathbb{I}(f(x)=y)} | 对抗攻击测试、输入扰动测试 |
工具生态:
| 评测工具 | 工具链接 |
|---|---|
| lm - evaluation - harness | https://github.com/EleutherAI/lm-evaluation-harness |
| OpenCompasss | https://opencompass.org.cn/ |
(待补充完善)
2. 人工评估(Human Evaluation)
评估框架:
| 关键要素 | 要求说明 |
|---|---|
| 评估者数量 | 每组≥3人,保证统计显著性 |
| 评估标准 | 准确性、相关性、流畅性、安全性、透明度、安全性、人类一致性等 |
| 评估者资质 | 领域专家占比≥30%,均需通过评估培训 |
实施流程:
-
设计评估矩阵:
# 评估维度权重配置示例 criteria = { '准确性': 0.3, '相关性': 0.2, '流畅性': 0.15, '安全性': 0.2, '透明度': 0.15 } -
执行双盲评估:评估者不知晓模型版本信息
-
统计分析:使用Krippendorff's alpha系数计算评分者间信度
评估方法对比
| 维度 | 自动评估 | 人工评估 |
|---|---|---|
| 执行成本 | 低 | 高 |
| 评估周期 | 分钟级 | 天级 |
| 可解释性 | 量化结果明确但可解释性差 | 可提供定性反馈 |
| 适用范围 | 标准化任务(分类、生成等) | 创造性任务(写作、设计等) |
3. 前沿评估方法探索
除了上述两种评估方式之外,现在还出现了一些前沿的评估方法,例如:
思维链评估(CoT Evaluation):
# 使用GPT-4进行自动评估
def cot_evaluation(prompt, response):
    evaluation_prompt = f"""
    请评估以下回答的质量(1-5分):
    问题:{prompt}
    回答:{response}
    评估标准:
    1. 事实准确性 2. 逻辑连贯性 3. 潜在危害性
    """
    return gpt4_api(evaluation_prompt)

# 执行批量评估
scores = [cot_evaluation(p, r) for p, r in zip(prompts, responses)]
多模态评估框架:
graph TD
    A[输入] --> B[文本分析]
    A --> C[图像识别]
    A --> D[语音处理]
    B --> E[语义理解评分]
    C --> F[视觉一致性评分]
    D --> G[语音自然度评分]
    E --> H[综合评估]
    F --> H
    G --> H
论文启示:最新研究显示,结合自动评估的效率与人工评估的深度,采用「AI-Human Hybrid」模式可获得最优评估效果(Bubeck et al., 2023)
内容小结
-
大模型评测至关重要:
- 它有助于我们更好地了解大模型优势和劣势。
- 可以更好地为人类与大模型的交互提供指导。
- 更好地统筹和规划大模型未来的发展和演变。
-
大模型评测的评价体系
- 评价体系需要包含可靠性、安全性、公平性、抵御滥用能力、可解释性与推理能力、社会规范、鲁棒性等维度。
- 评价体系需要包含通用语言任务、特定下游任务、多模态任务等领域的评价。
-
大模型评测的评价方法
- 评价方法需要包含自动评估、人工评估两种方法。
- 自动评估借助工具进行自动化评估,主要评估的指标有:精确匹配(EM)、F1 Score、ROUGE-L、校准度、公平性、鲁棒性等。
- 人工评估需要借助人工进行评估,主要评估的指标有:准确性、相关性、流畅性、安全性、透明度、安全性、人类一致性等。
- 除了上述两种评估方法之外,现在还出现了一些前沿的评估方法,例如:思维链评估、多模态评估等。
参考资料
- 《A Survey on the Evaluation of Large Language Models》
- 《Trustworthy LLMs: a Survey and Guideline for Evaluating Large Language Models’ Alignment》
- 知乎:“评测即科学”:首篇大语言模型评测的综述,一文带你全面了解大模型评测的现状、方法和挑战
附录
其他文章
- 【模型测试】大模型测评体系的构成
- 【模型测试】大模型评测工具lm-evaluation-harness的使用方法总结
- 【模型测试】大模型评测工具OpenCompass使用方法总结
- 【模型测试】ai-eval-system在线评测系统v0.2预览版本介绍
欢迎关注公众号以获得最新的文章和新闻