【项目实战】第3篇:SDD 规格驱动开发教程——越加功能,AI 越开始「编」
系列:《用 AI 写出高质量代码:AI 狼人杀开发实录》 本篇对应版本:v1.3 → v1.4.1|时间:2026-10-22 下午
前言
前两篇解决了两件事:AI 说的每句话都是真的、规则跑在服务器上。到这一步,产品已经能玩了,我开始加功能。
然后我发现,代码没崩,是“需求”开始崩了。
这一篇讲 SDD(Spec-Driven Development,规格驱动开发):它是什么、为什么能治这个病、边界在哪。
引子:我只说了“加个守卫”
我记得很清楚,那天我想加一个新角色。原话大概是:“加个守卫,晚上能守一个人。”
AI 给了我一套很完整的实现:角色定义、夜间行为、和女巫的解药结算顺序、界面上的提示文案,甚至还有一条规则——“守卫不能连续两晚守同一个人”。
这条规则是对的(狼人杀里确实这么打),但我没有说过。
那天下午它还干了另外两件事:
- 我让它改对局页的发言气泡,它顺手把结算页的字段名一起改了,结算页直接白屏;
- 我第二天开新对话继续,它不知道项目里已经有
RoleBehavior注册表,重新写了一版if-else。
三件事,同一个病根:它不知道边界在哪,于是用“最像的写法”去猜。
问题:AI 的“补全冲动”
大模型是一个“补全机器”。你给它半个句子,它想给你一个完整的段落。这在写文案时是优点,在写代码时是灾难——
- 你说“加个守卫”,它补全成“一个符合狼人杀惯例的守卫”,于是多了两条你没要的规则;
- 你说“改发言气泡”,它补全成“把这一块相关代码都整理一下”,于是碰到了结算页;
- 你说“实现夜间行为”,它不知道已经有注册表,补全成“自己写一套”。
三个症状,本质是上下文不足 + 边界不清。而这两样,恰好都是“文档”能解决的。
问题原因:什么是 SDD
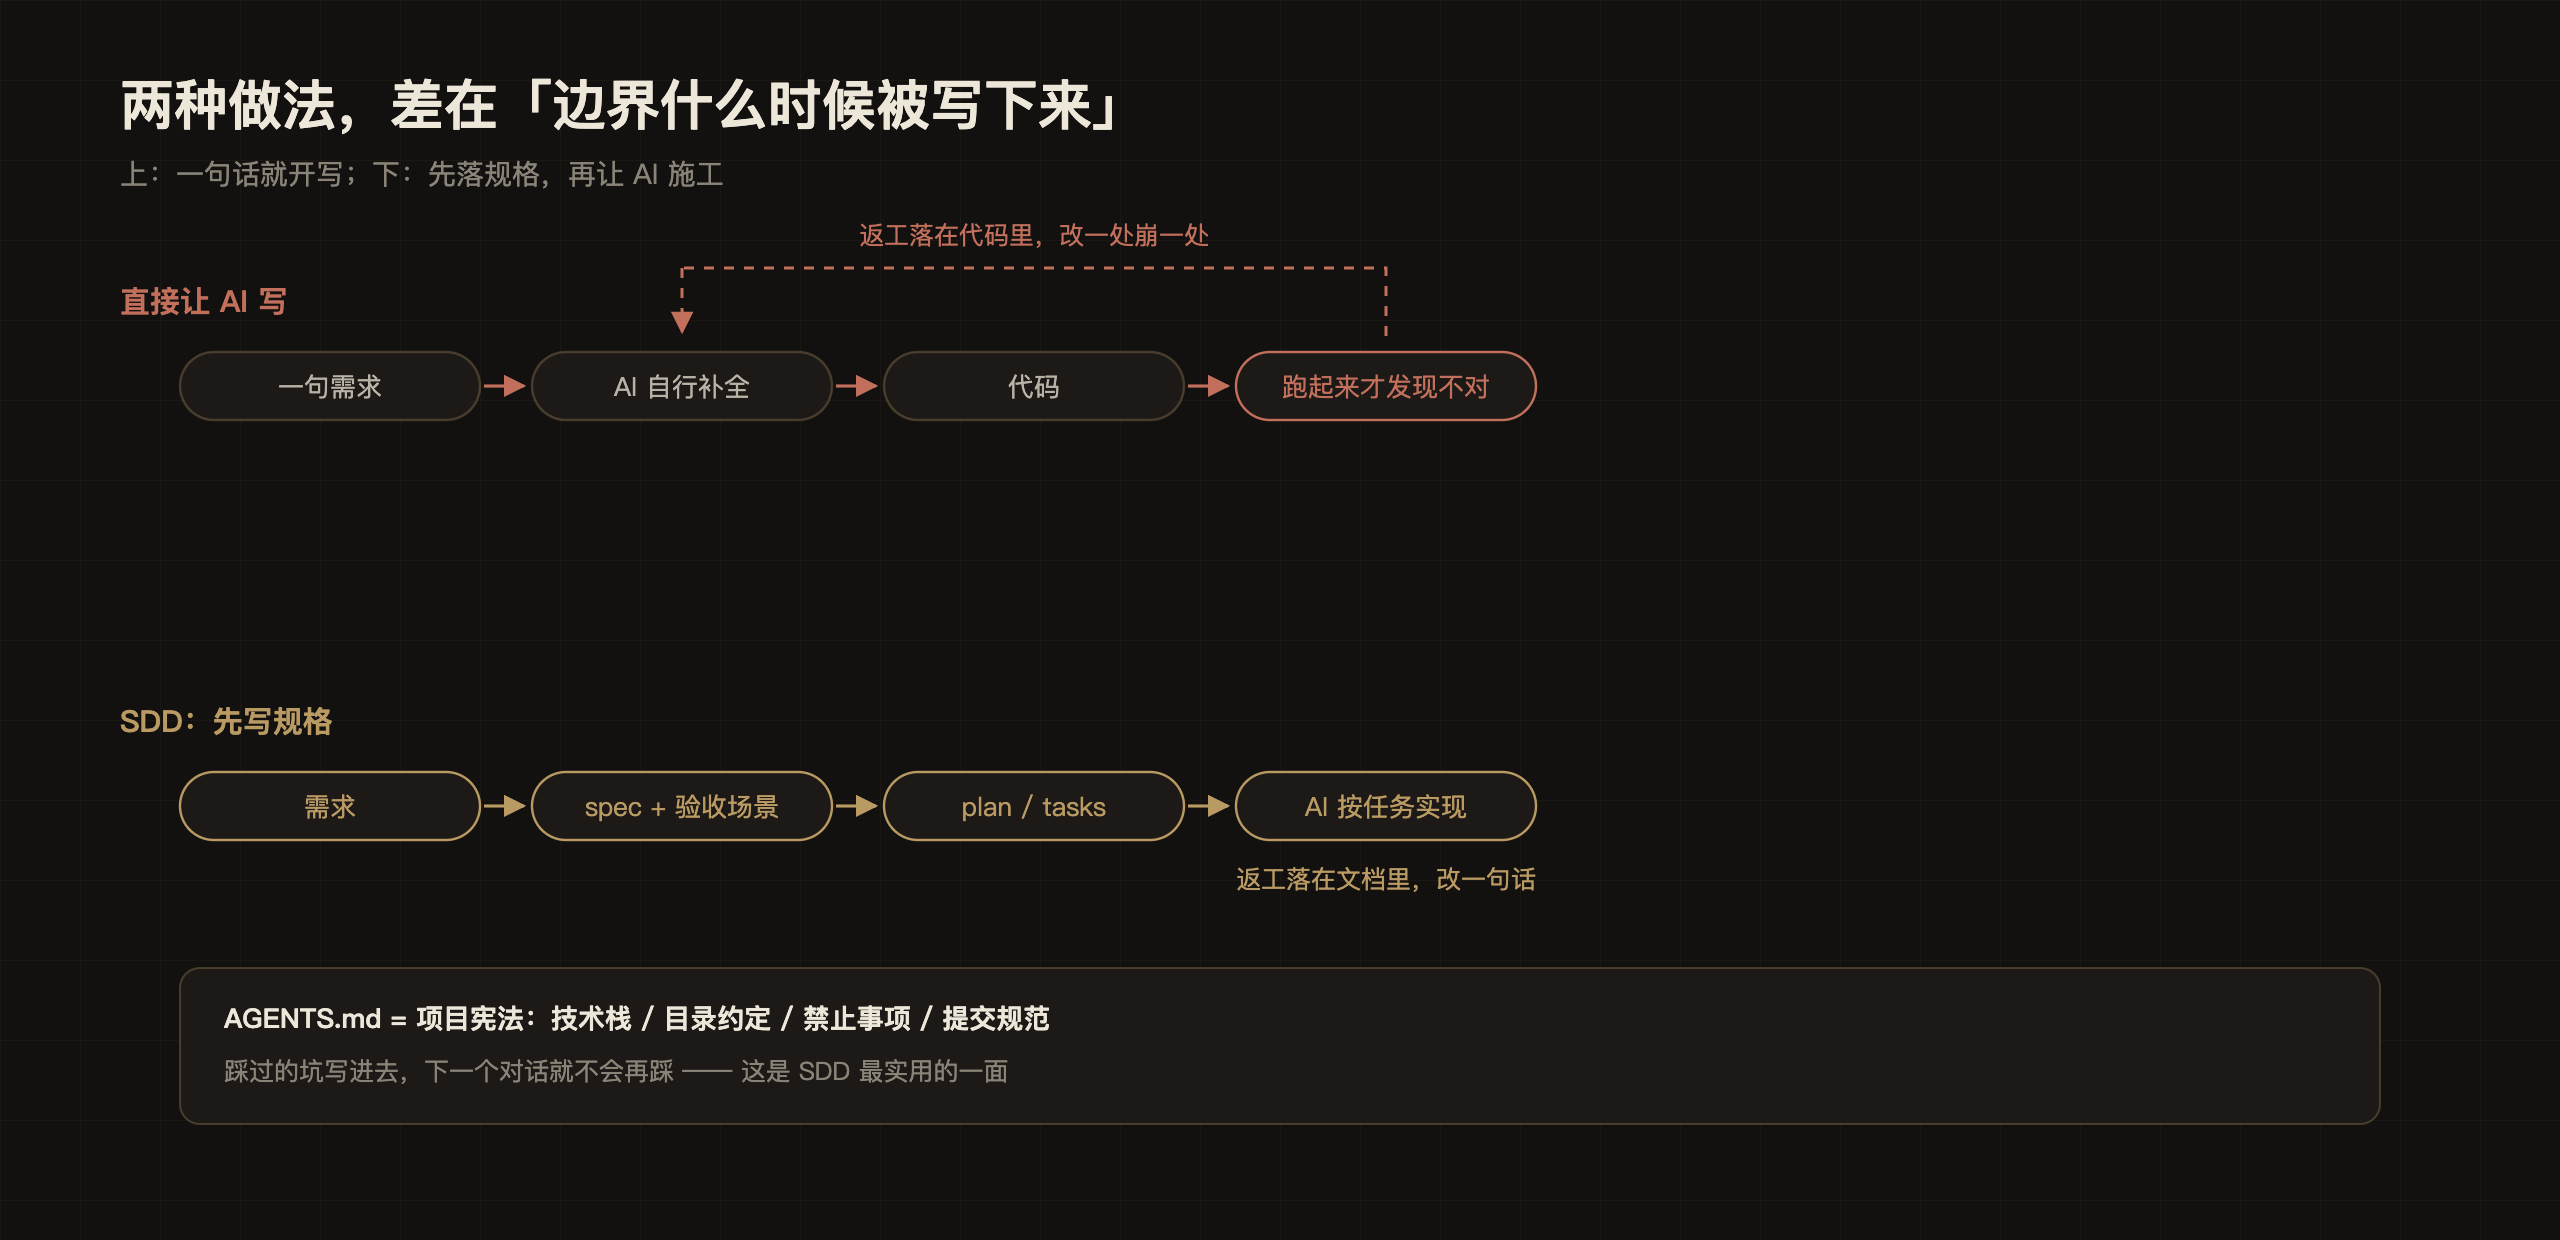
图:两种做法的差别不在“写得快不快”,而在返工落在哪。上图一句话开写,需求被 AI 补全,问题在代码里才暴露,回到起点要改一堆文件;下图先把规格和验收场景写下来,返工发生在文档里,改一句话就行。
一句话定义
SDD = 先写规格,再让 AI 按规格实现。
不是“写文档给领导看”,而是把“你要什么”变成 AI 能读、能验收的东西。规格写完,AI 的输出范围就被框住了。
和“直接让 AI 写”的区别
| 直接让 AI 写 | SDD | |
|---|---|---|
| 需求漂移 | 高(它会补充、会发挥) | 低(超出规格的部分会被你打回) |
| 返工位置 | 代码里(改一处崩一处) | 文档里(改一句话就行) |
| 上下文占用 | 每次对话都要重新解释项目 | 规格 + 项目宪法,一次说清 |
| 可追溯性 | 靠记忆 | 每条需求有编号,验收有场景 |
| 前期速度 | 快 | 慢(要先写文档) |
优势:三个“省”
- 省解释:新开一个对话,AI 读
AGENTS.md+spec.md就知道规矩,不用我重讲一遍项目。 - 省返工:需求阶段改一句话,比代码阶段改十个文件便宜得多。
- 省争议:验收标准写在那里,“做没做完”不靠感觉。
AGENTS.md 是什么
如果 spec 是“这一版要做什么”,AGENTS.md 就是“在这个项目里怎么干活”。它被所有编码 Agent 读(Claude Code、WorkBuddy、CodeBuddy、Codex、Cursor 都认这个文件名)。
我这个项目里它 185 行,开头四节是这样的:
## 2. 四条红线(违反即返工)

1. **AI 言行必须由模型生成**。禁止兜底话术、规则模板。模型失败就明确中止并说原因(fail-fast)。
2. **服务端权威**。身份、夜间行动、随机数、胜负判定只存在于 src/game/engine.ts。
   前端只能拿到投影,任何接口都不得泄露未公开信息。
3. **身份只走一条路**。用户 token 放在 X-WW-Token 头里(Authorization 会被平台网关覆盖)。
4. **配置不入库**。config/cloud.json 只在本地。
解析: 这四条不是“建议”,是“违反即返工”。前两条正是第 1、2 篇踩出来的教训——我把它们固化成了红线,这样后面每一次对话,AI 都会先读到它们。
这就是 SDD 最实用的一面:把踩过的坑写成规则,坑就不会踩第二次。
解决方案:三步搭起规格体系
第一步:接入 spec-kit
# 用 uvx 直接跑,不污染项目环境(需要先装 uv)
uvx --from git+https://github.com/github/spec-kit.git specify init

# 初始化后目录里会多出 .specify/,命令是 /specify /plan /tasks
第二步:把 PRD 写成“可验收”的样子
我的 PRD 不是散文,是一张张带状态的表。比如角色库那张:
| 角色 | 阵营 | 门槛 | 能力 | 状态 |
|---|---|---|---|---|
| 狼人 | 狼 | ≥6 | 夜晚刀人 | ✅ |
| 守卫 | 好 | ≥8 | 每晚守护一人(不能连守) | ✅ |
| 白痴 | 好 | ≥9 | 首次被放逐翻牌免死,此后失去投票权 | ✅ |
| 摄梦人 | 好 | ≥12 | 每晚标记一人,被标者不能被刀 | 未实装 |
最后那一行很重要:它如实写着“未实装”,而不是假装做完了。 第 8 篇会讲到,这条诚实后来救了我一次——评审看到角色列表里“摄梦人”是灰的,如果 PRD 写着“已完成”,那就是硬伤。
第三步:一条好需求长什么样
这是本篇最想让你带走的东西。对比一下:
反例(我第一天的说法):
加个守卫角色,晚上能守一个人。
正例(spec.md 里的写法):
守卫
- 每夜可守护一人,不能连续两夜守护同一人;
- 被守护者当夜免于狼刀,但不免于女巫毒药;
- 守卫可以守自己;
- 与女巫解药同时作用于同一人时,按“同守同救则死”处理(本局规则,需在提示文案中说明);
- 验收:构造「守卫守 A + 狼刀 A」得到 A 存活;构造「守卫守 A + 女巫毒 A」得到 A 死亡。
解析: 差别在三点——
- 边界:“不能连续两夜守同一人”写在需求里,AI 就不会“帮你补”;
- 例外:免刀不免毒,这种反直觉的地方必须写,否则 AI 一定按直觉写;
- 验收:给了两个可执行的场景。“做没做完”变成可判定的,而不是“我看着像做完了”。
我后来发现,写验收场景这件事本身,就能提前发现一半的需求漏洞。写“免不免毒”的时候我才意识到,我自己都没想清楚。
第四步:spec 三件套怎么配合
specs/001-lobby-spectate/
├── spec.md     ← 要什么(用户故事 + 验收场景)
├── plan.md     ← 怎么做(技术选型、数据流)
└── tasks.md    ← 做什么(可勾选的任务清单)
我的做法是:spec.md 长期保留(它是需求的事实源),plan.md 和 tasks.md 做完就删——它们的价值在“过程”,不在“存档”。留着只会积灰、过期、然后误导下一次的 AI。
效果:返工从代码搬到了文档
三个可观察的变化:
- 需求漂移停了。AI 再"补"东西,我能指着 spec 说"这条不在范围内",它不会争。
- 新开对话不用重讲项目。
AGENTS.md一读,四条红线就在它眼前。 - 验收清单直接变成测试用例。第 9 篇那 324 个用例里,有一批就是从"验收场景"逐条翻译过去的。
效果最直接的是"守卫"那条需求。原来我说"加个守卫",它补了两条我没要的规则;写成规格之后,边界、例外、验收三样都在纸上:
守卫:每夜可守护一人,不能连续两夜守护同一人;被守护者当夜免于狼刀,但不免于女巫毒药;验收:构造「守卫守 A + 狼刀 A」得 A 存活,构造「守卫守 A + 女巫毒 A」得 A 死亡。
这条写完之后,它没有再"自由发挥"过一次。
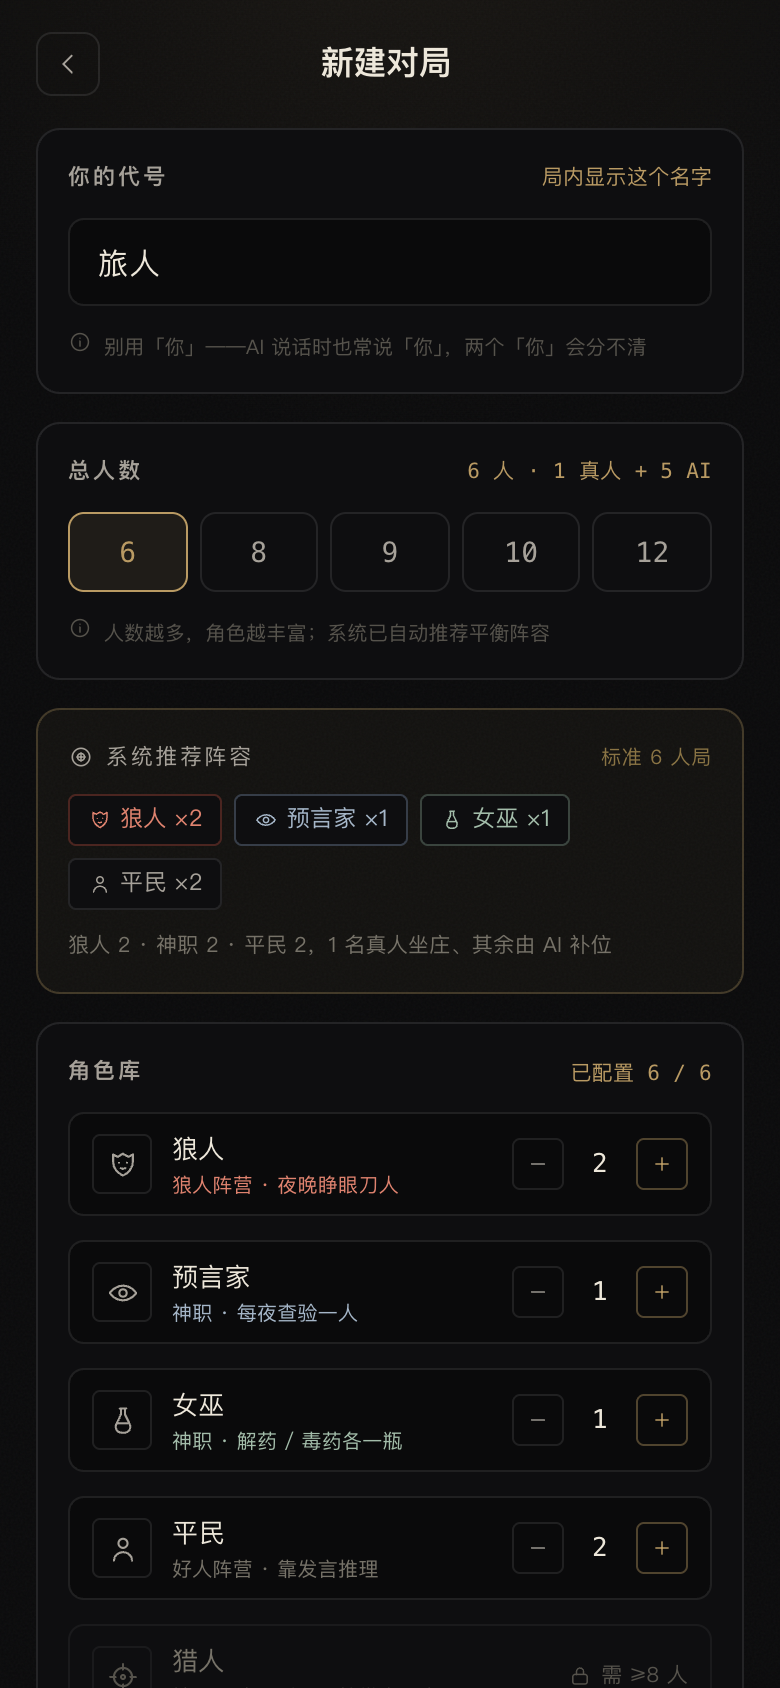
图:建局配置页(v1.5 的稳定形态)。人数、角色、校验规则都在这张表上——规格落到界面的样子。
内容小结
- AI 是补全机器:你给半个需求,它还你一个“符合惯例”的完整实现——包括你没要的部分。
SDD的本质是把边界写下来,不是写文档交差。边界包括:做什么、不做什么、怎么算做完。- 一条好需求 = 能力 + 例外 + 验收场景。缺哪一条,AI 就会在那一条上发挥。
AGENTS.md是性价比最高的文档:185 行,管住后面所有对话的行为边界。把踩过的坑写进去,坑就不会踩第二次。- 文档必须有人维护,否则它比没有文档更危险——AI 会认真执行一份过期的规格。
- 可迁移吗? 越是长期、越是多人(或多
Agent)协作,SDD收益越大。一次性脚本没必要。
参考资料
- spec-kit:
github.com/github/spec-kit - 项目仓库:
werewolf-ai的AGENTS.md、docs/PRD.md、specs/001-lobby-spectate/spec.md - 上一篇:第2篇:JavaScript 与 Node.js 教程——换个窗口就能作弊
- 下一篇:第4篇:代码重构教程——一个文件三千行,技术债把 AI 拖垮了
[评论 0]
评论加载中…