【项目实战】第4篇:代码重构教程——一个文件七百行,技术债把 AI 拖垮了
系列:《用 AI 写出高质量代码:AI 狼人杀开发实录》 本篇对应版本:v1.5 → v1.8|时间:2026-10-22 傍晚
前言
前三篇在讲“怎么让 AI 做对”。这一篇讲一件更隐蔽的事:AI 会跟着你的坏结构一起烂下去。
引子:我让 AI 审自己的代码,它给了我一份账单
那天我没写新功能,只做了一件事:让 AI 把我写的代码通读一遍,出一份评审报告。
它读完给了三级清单:P0 阻断 3 项、P1 规范性 6 项、P2 可扩展性 11 项,末尾还附了三个评分——规范性 6.5、封装性 7.5、可扩展性 6.0。
其中两行,我看了很久:
engine.ts724 行(自定上限 350) 角色能力散落 15 处if,加一个角色要改 5~8 处
技术债最麻烦的地方就在这里:它在账本上,但账本不在你眼前。 你感觉不到它,直到某一天你发现“改一句提示文案”都要先读三百行。
问题:不是 AI 变笨了,是它读不全了
三个连锁反应,一个比一个难查:
- 读不全就敢写。模型一次能看的代码有限,超出部分它看不到,但它不会说“我没看到其余部分”,它会用最像的写法补齐。
- 同一个判断散落多处。改了三处漏两处,程序不报错,只是行为变了。
- 没有测试兜底。当时前端测试是 0 个,只能“玩一局看看”——一局八分钟,一天验不了几次。
这三条不是并列关系,是递进:读不全 → 漏改 → 而漏改没人拦得住。
问题原因:技术债与上下文窗口
先看账本。下面这张图里的每个数字,都来自那份评审报告,不是我事后凭感觉估的:
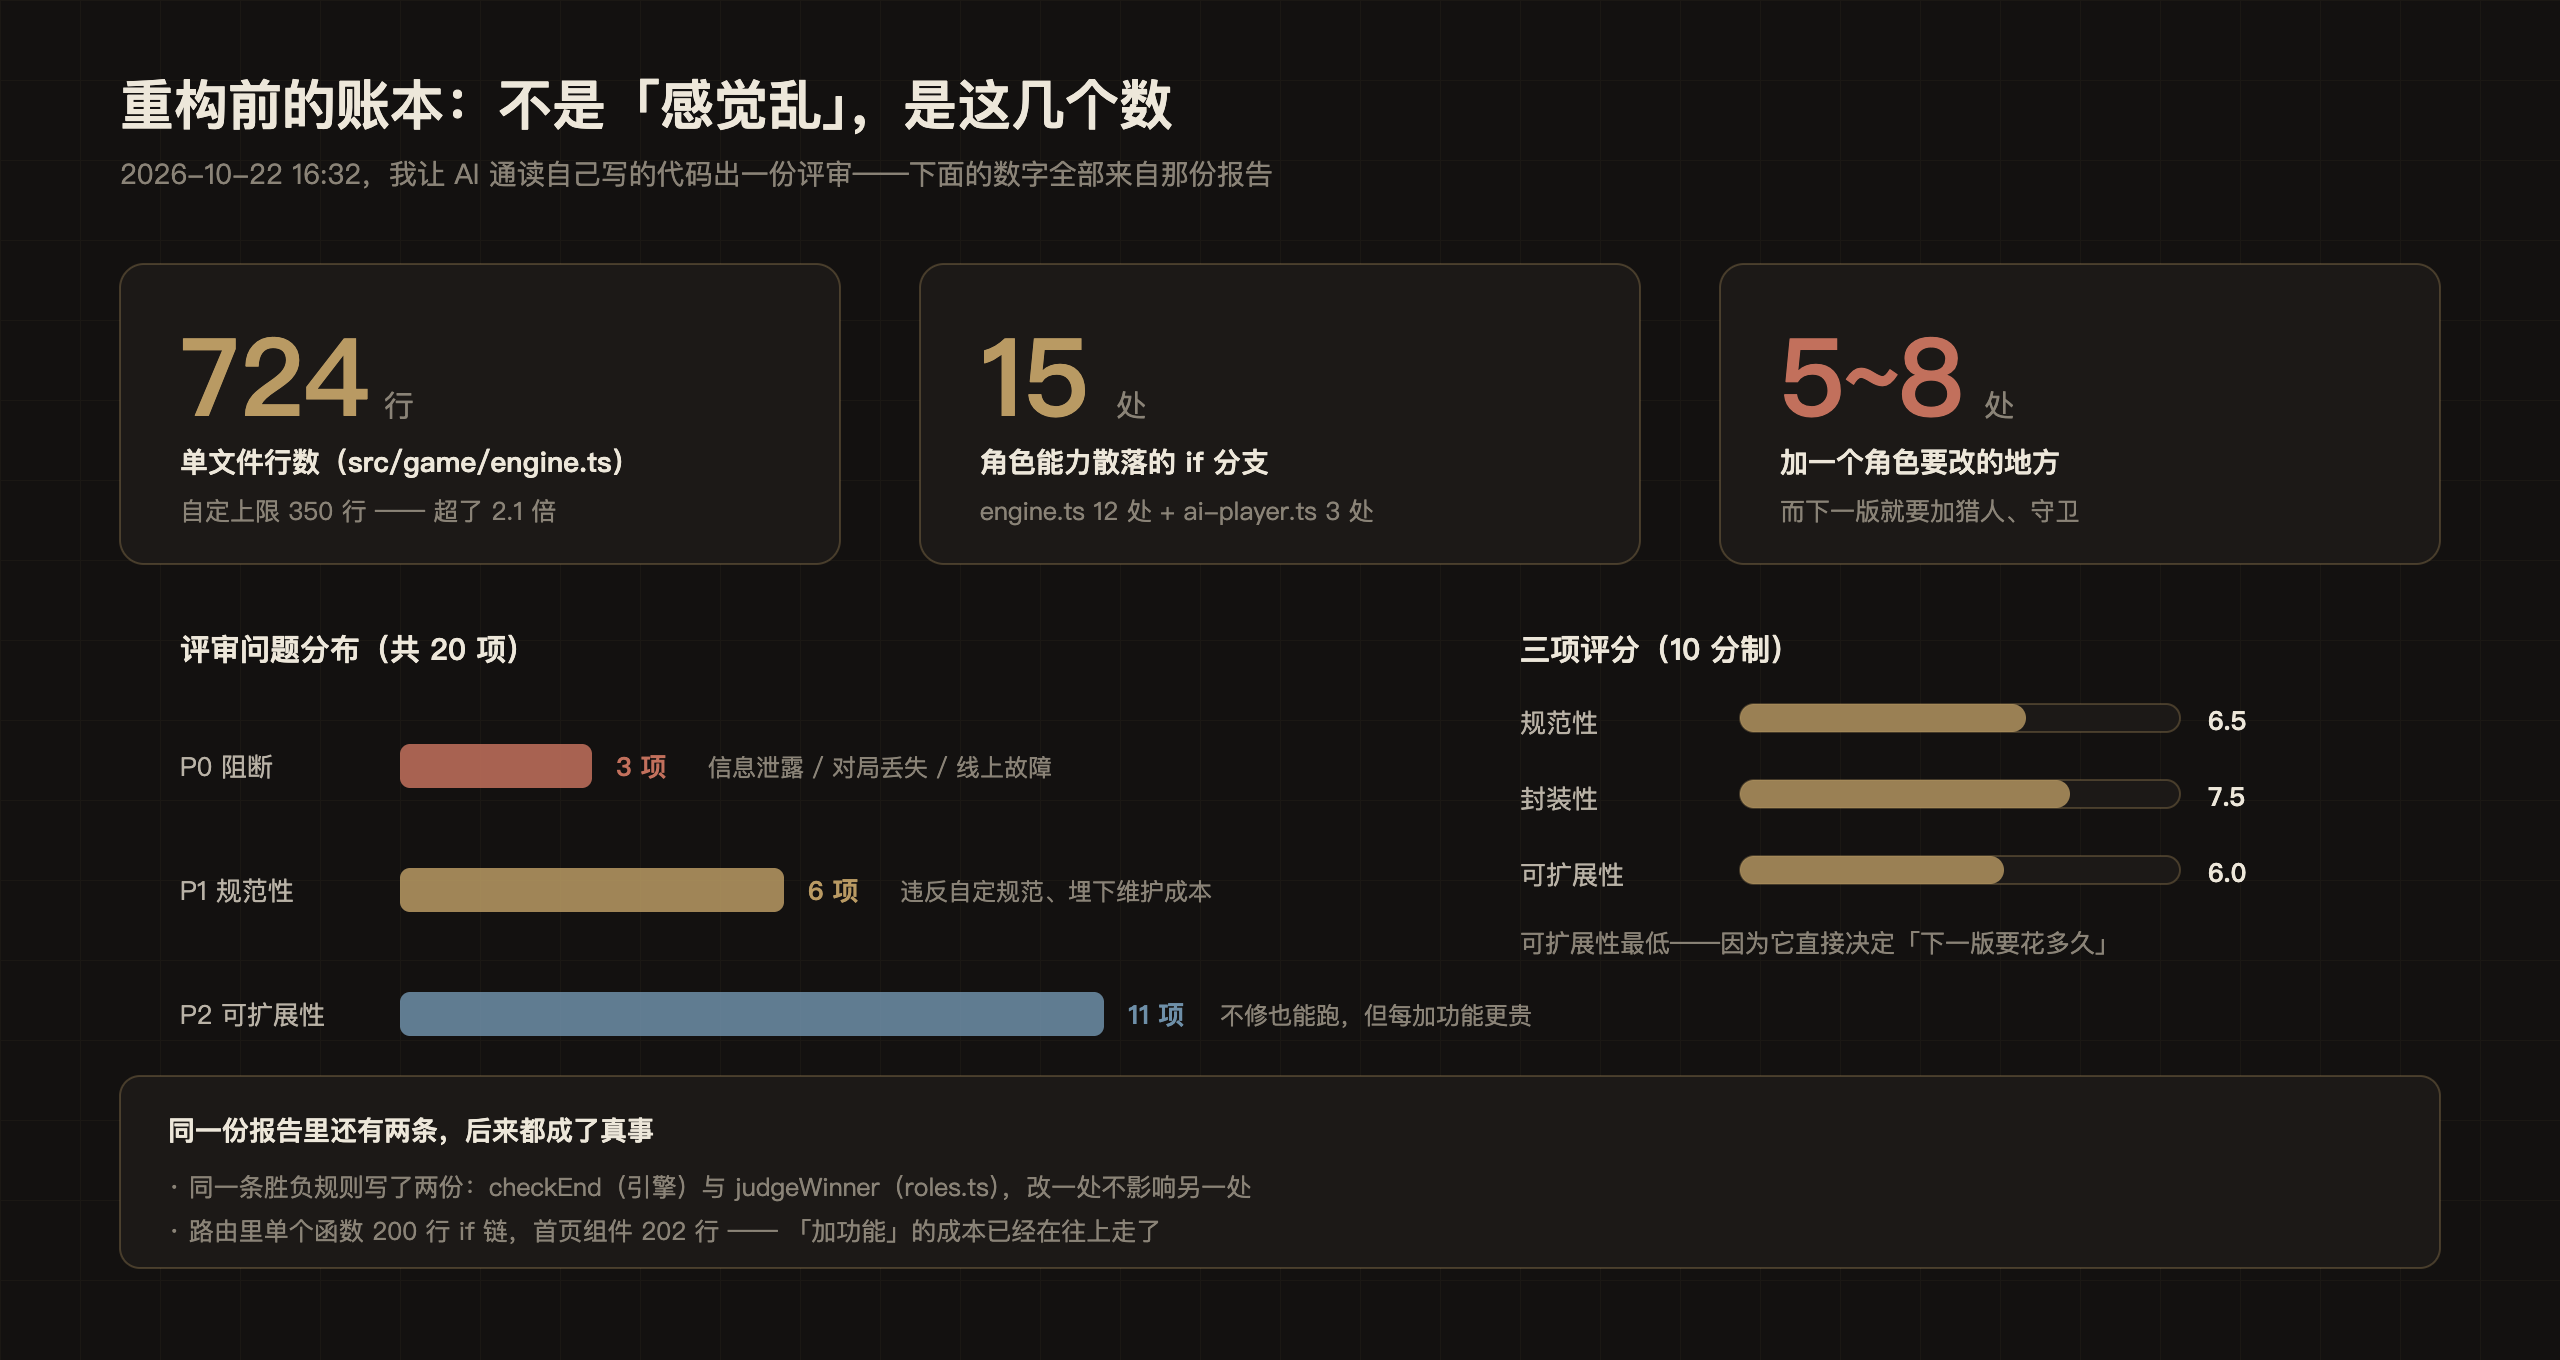
图:重构前的账本。最左边的数字最刺眼——单文件 724 行,而它自己的上限是 350 行;最要命的是右边那个「5~8 处」,它决定了下一版的工作量。
「15 处 if」到底长什么样
15 这个数字不是估的,报告里拆得很细:
P2-1
engine.ts12 处、ai-player.ts3 处role === 'xxx'。角色能力靠if分支散落各处,加一个角色要改 5~8 处,且容易漏(比如忘加gameMates初始化)。
光看数字还是没有体感。把当时的 night() 挖出来看,是这样的:
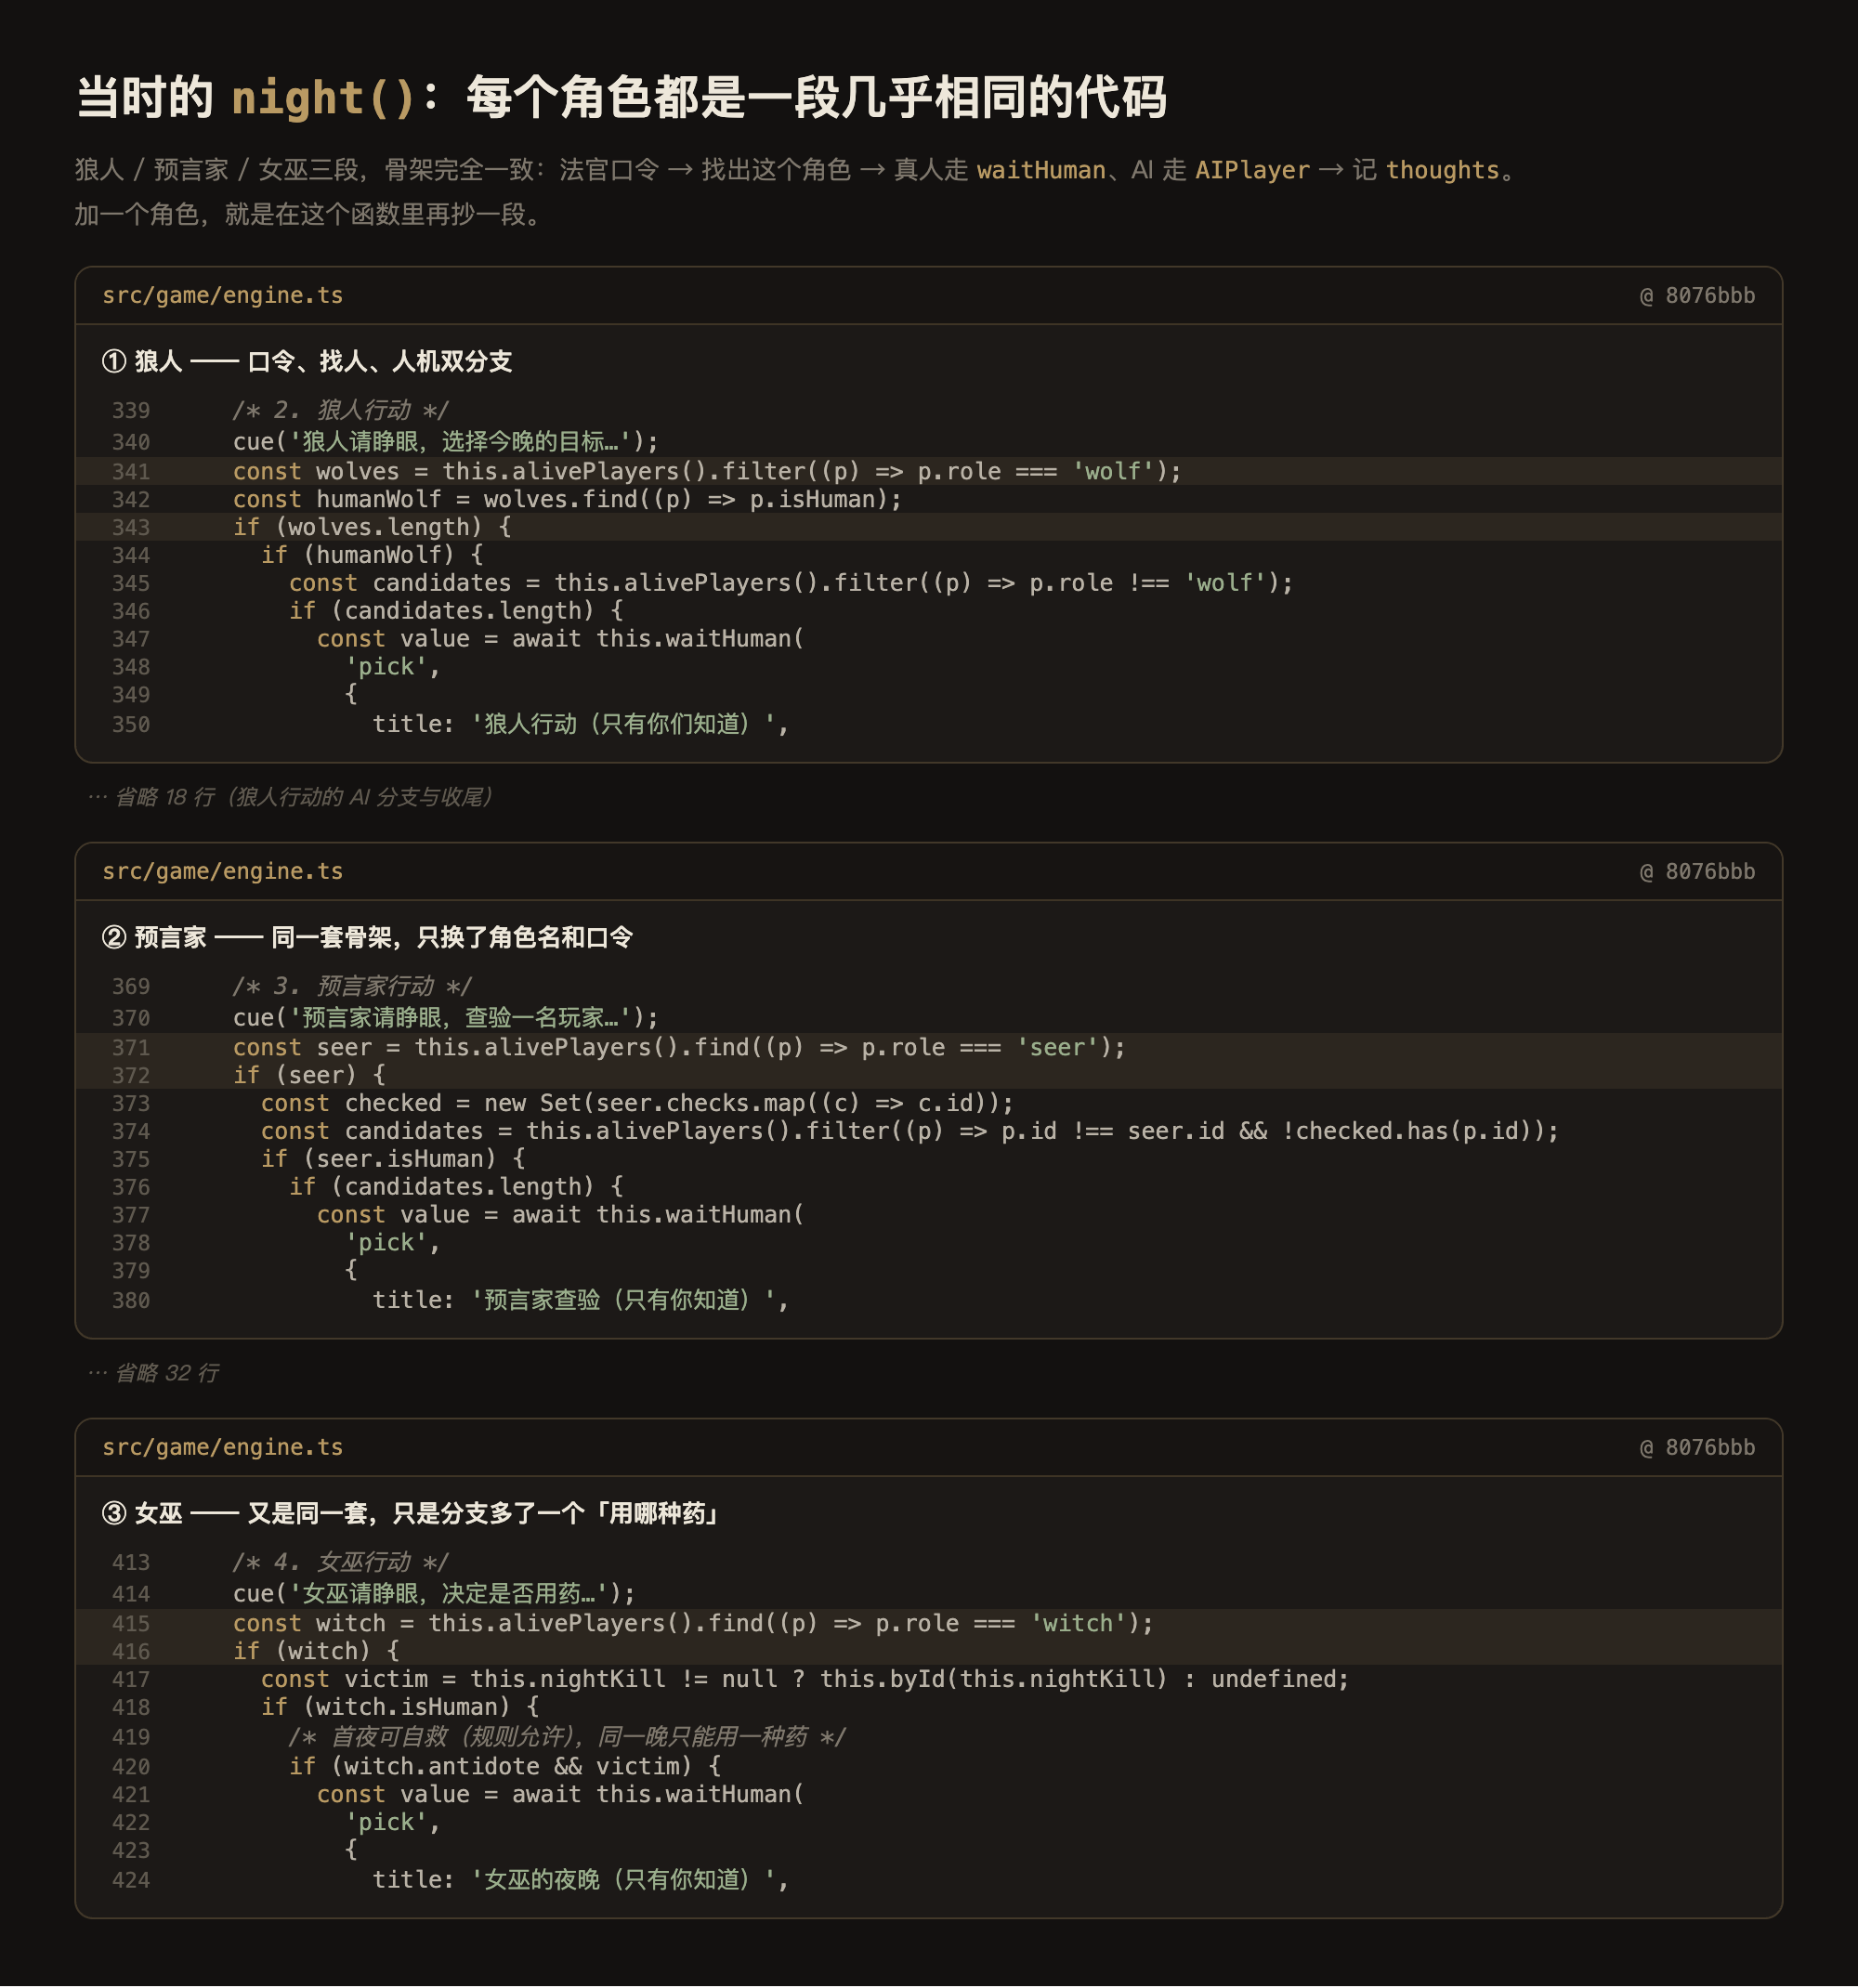
图:狼人、预言家、女巫,三段的结构一模一样。加一个角色,就是在这个函数里再抄一段。
三段代码的骨架完全一致:发法官口令 → 找出这个角色 → 真人走 waitHuman、AI 走 AIPlayer → 记 thoughts。这不是复制粘贴出来的,是每次加角色时“照着上一段写”自然长成的形状。 AI 不会主动说“这里该抽象了”,它只会按你代码里的既有风格补全——而你代码里的既有风格,就是继续抄。
这就是那句“加一个角色要改 5~8 处”的来源:夜里的流程一处、白天的判定一处、胜负条件一处、快照裁剪一处、前端展示一处……
为什么长文件对 AI 特别致命
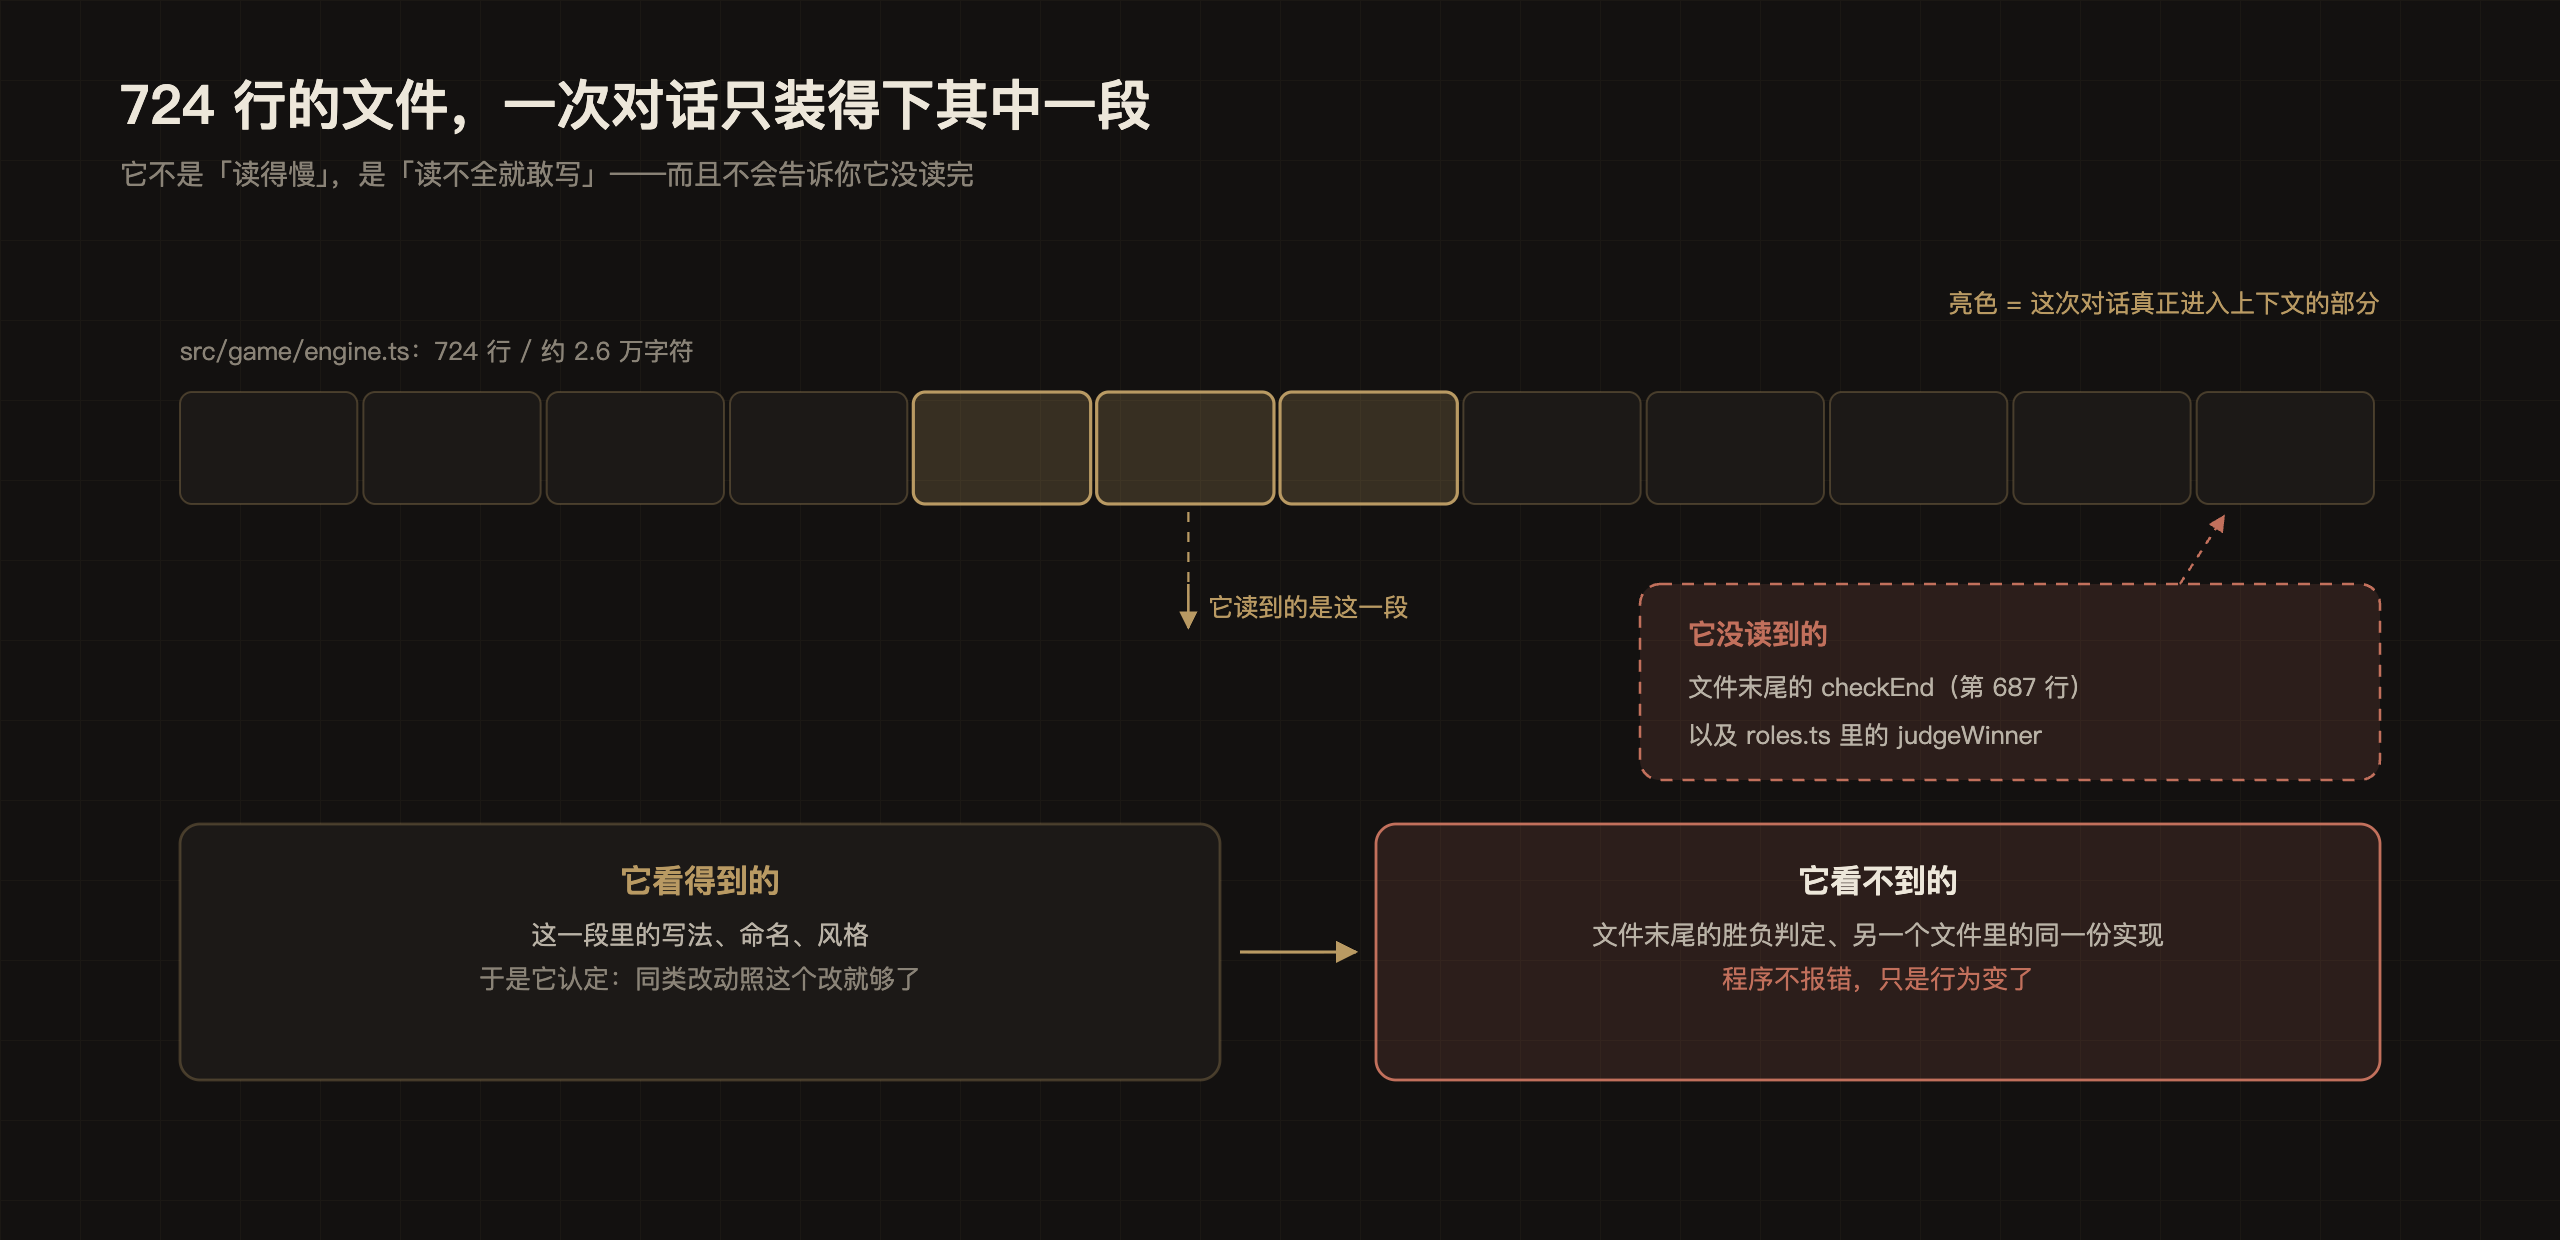
图:724 行的文件,一次对话只装得下中间一段。它没读到文件末尾的 checkEnd,更不会想到另一个文件里还有一份。
724 行、约 2.6 万字符,换算成 token 大约八千到一万。看起来不算多,但一次对话里还要放需求、放历史、放它自己的输出——真正留给“读代码”的空间往往只有一部分。
于是它读到的是一个片段。片段里的写法就是它的全部世界观。
关键认知:AI 不会因为“没看到”而降低置信度。 这是它和人的最大差别。人会犹豫,它不会。
一个可操作的判断标准
350 这个上限不是评审报告编的,是项目自己的能力约束,AGENTS.md 里写着:
小文件、单一职责,单文件尽量 ≤ 350 行;超了就抽模块(常量、类型、纯函数)。
规矩是自己写的,违反也是自己违的——这大概是技术债最典型的样子。除了行数,另外三条土规矩是那之后补的:单函数超过 50 行该拆;同一判断出现在 2 个以上地方该抽;改一处要同时改三个文件,说明边界划错了。
查起来很快:wc -l src/**/*.ts | sort -n | tail -10,看谁最胖。
重构前这个项目最胖的是引擎 724 行;现在是 1014 行——但那是因为它多扛了 5 个角色、观战和埋点,不是因为规则还堆在里面(这条曲线下面会讲)。
解决方案:重构提示词怎么写(本篇核心)
我觉得最有价值的部分不是“拆成什么样”,而是我怎么跟 AI 说这件事。
因为重构最容易翻车的地方是:AI 顺手把逻辑也改了。 你让它搬家,它顺手重新装修。
这是我用了很多次、后来固化下来的模板,可以直接复制:
背景:
1、狼人杀项目迭代到 v1.7,engine.ts 已 700 多行,每加一个角色都要改好几处
2、项目根目录有 AGENTS.md,写了单文件行数上限、常量管理、分层这些自家约束

目标:
1、先出一份重构评估,不要直接改代码

流程:
1、规范性:文件长度是否符合 AGENTS.md 的要求;有没有硬编码和魔术数字;常量是否统一管理
2、封装性:展现层、路由层、数据层、服务层是否分得开
3、组织与命名:目录结构、文件名、方法名是否符合行业最佳实践

要求:
1、按 P0 / P1 / P2 分级,每条给文件、行号、出现次数,不要给形容词
2、不确定的列出来问我,不要自己决定

输出位置:docs/CODE-REVIEW-2026-10-22.md
拆出来的样子
最后的结果就是现在这套结构:game(规则)、ai(决策)、server(HTTP)、cloud(存储),互不认识对方的细节。
其中最有价值的一次抽象,是把“角色夜间行为”从引擎主体里搬了出来——引擎暴露一组被刻意收窄的能力(读视图、发法官口令、设置守卫/狼人击杀),每个角色只实现一个 act():
export interface RoleBehavior {
  role: RoleKey;
  openCue: string;   // 「守卫请睁眼…」
  closeCue: string;  // 「守卫请闭眼」
  act(host: NightHost, actor: Player): Promise<void>;
}
引擎只负责“按顺序遍历 + 发口令 + 结算”。加一个新角色,等于新建一个对象 + 注册进去,引擎主体一行不改。
效果:改动落在该落的地方
重构那一天的结果,可以一句话说完:引擎 808 行 → 723 行,新增 behaviors.ts 191 行,87 个用例全绿。
虽然整体行数减少得不多,但注册制让行为完全不变——注册一个新角色,现在只加一行:
/* 新增角色 = 新建行为对象 + 注册进表,引擎主体不动 */
export const NIGHT_BEHAVIORS: RoleBehavior[] = [
  wolfBehavior, seerBehavior, witchBehavior, hunterBehavior, guardBehavior,
];
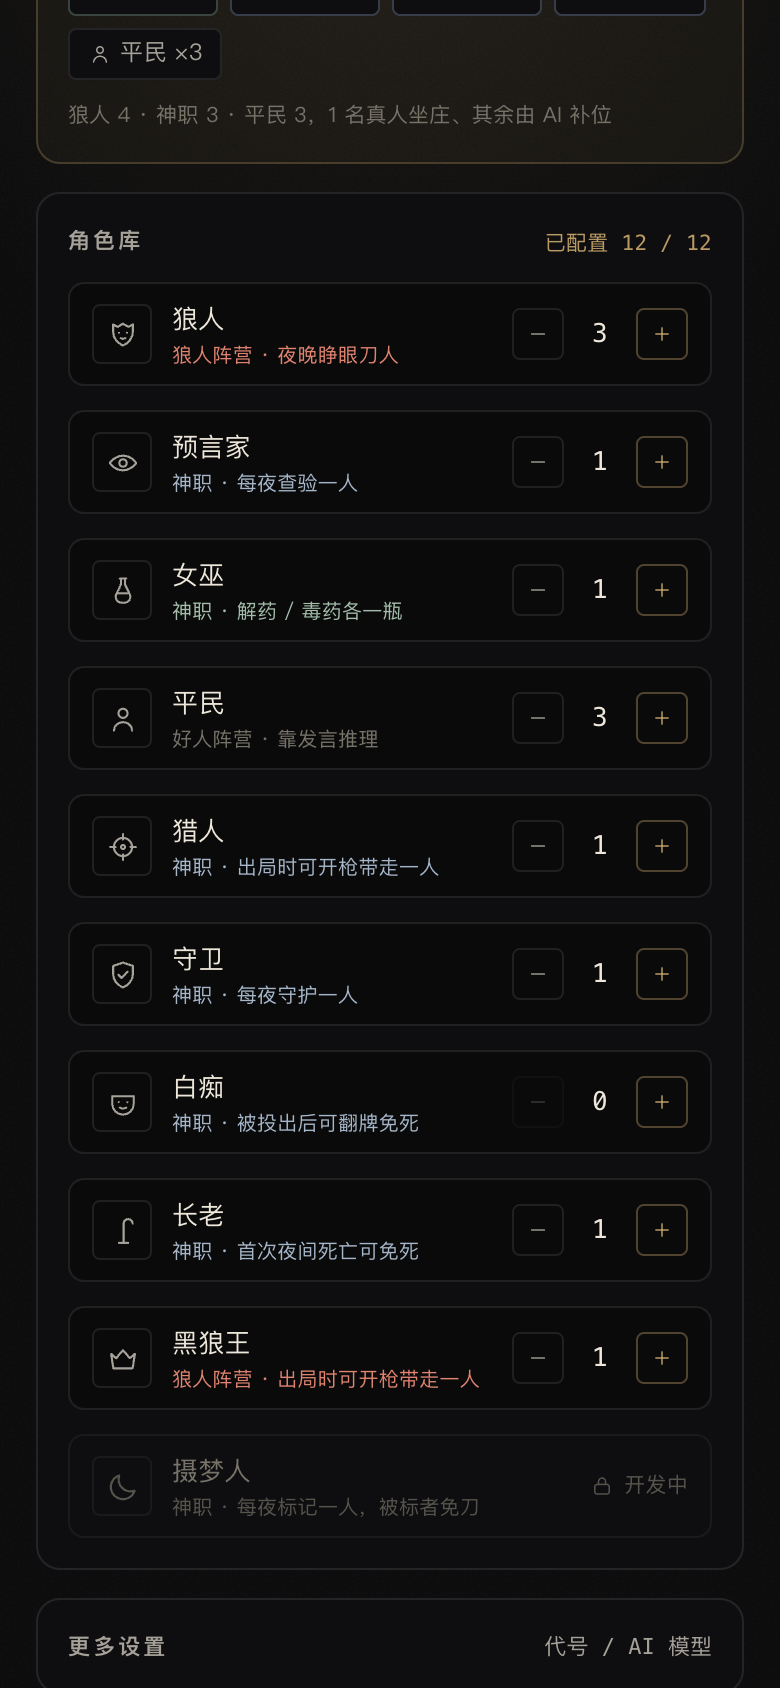
图:建局配置页(v1.8,从当时的提交跑出来的,切到 12 人局)。9 个角色各自一份牌、各自一个门槛,摄梦人还锁在「开发中」——加一张牌,不影响别的牌。
但这条曲线后来反弹了
如果只写上面的结果,这篇就变成了粉饰。真实的数据是这样的:
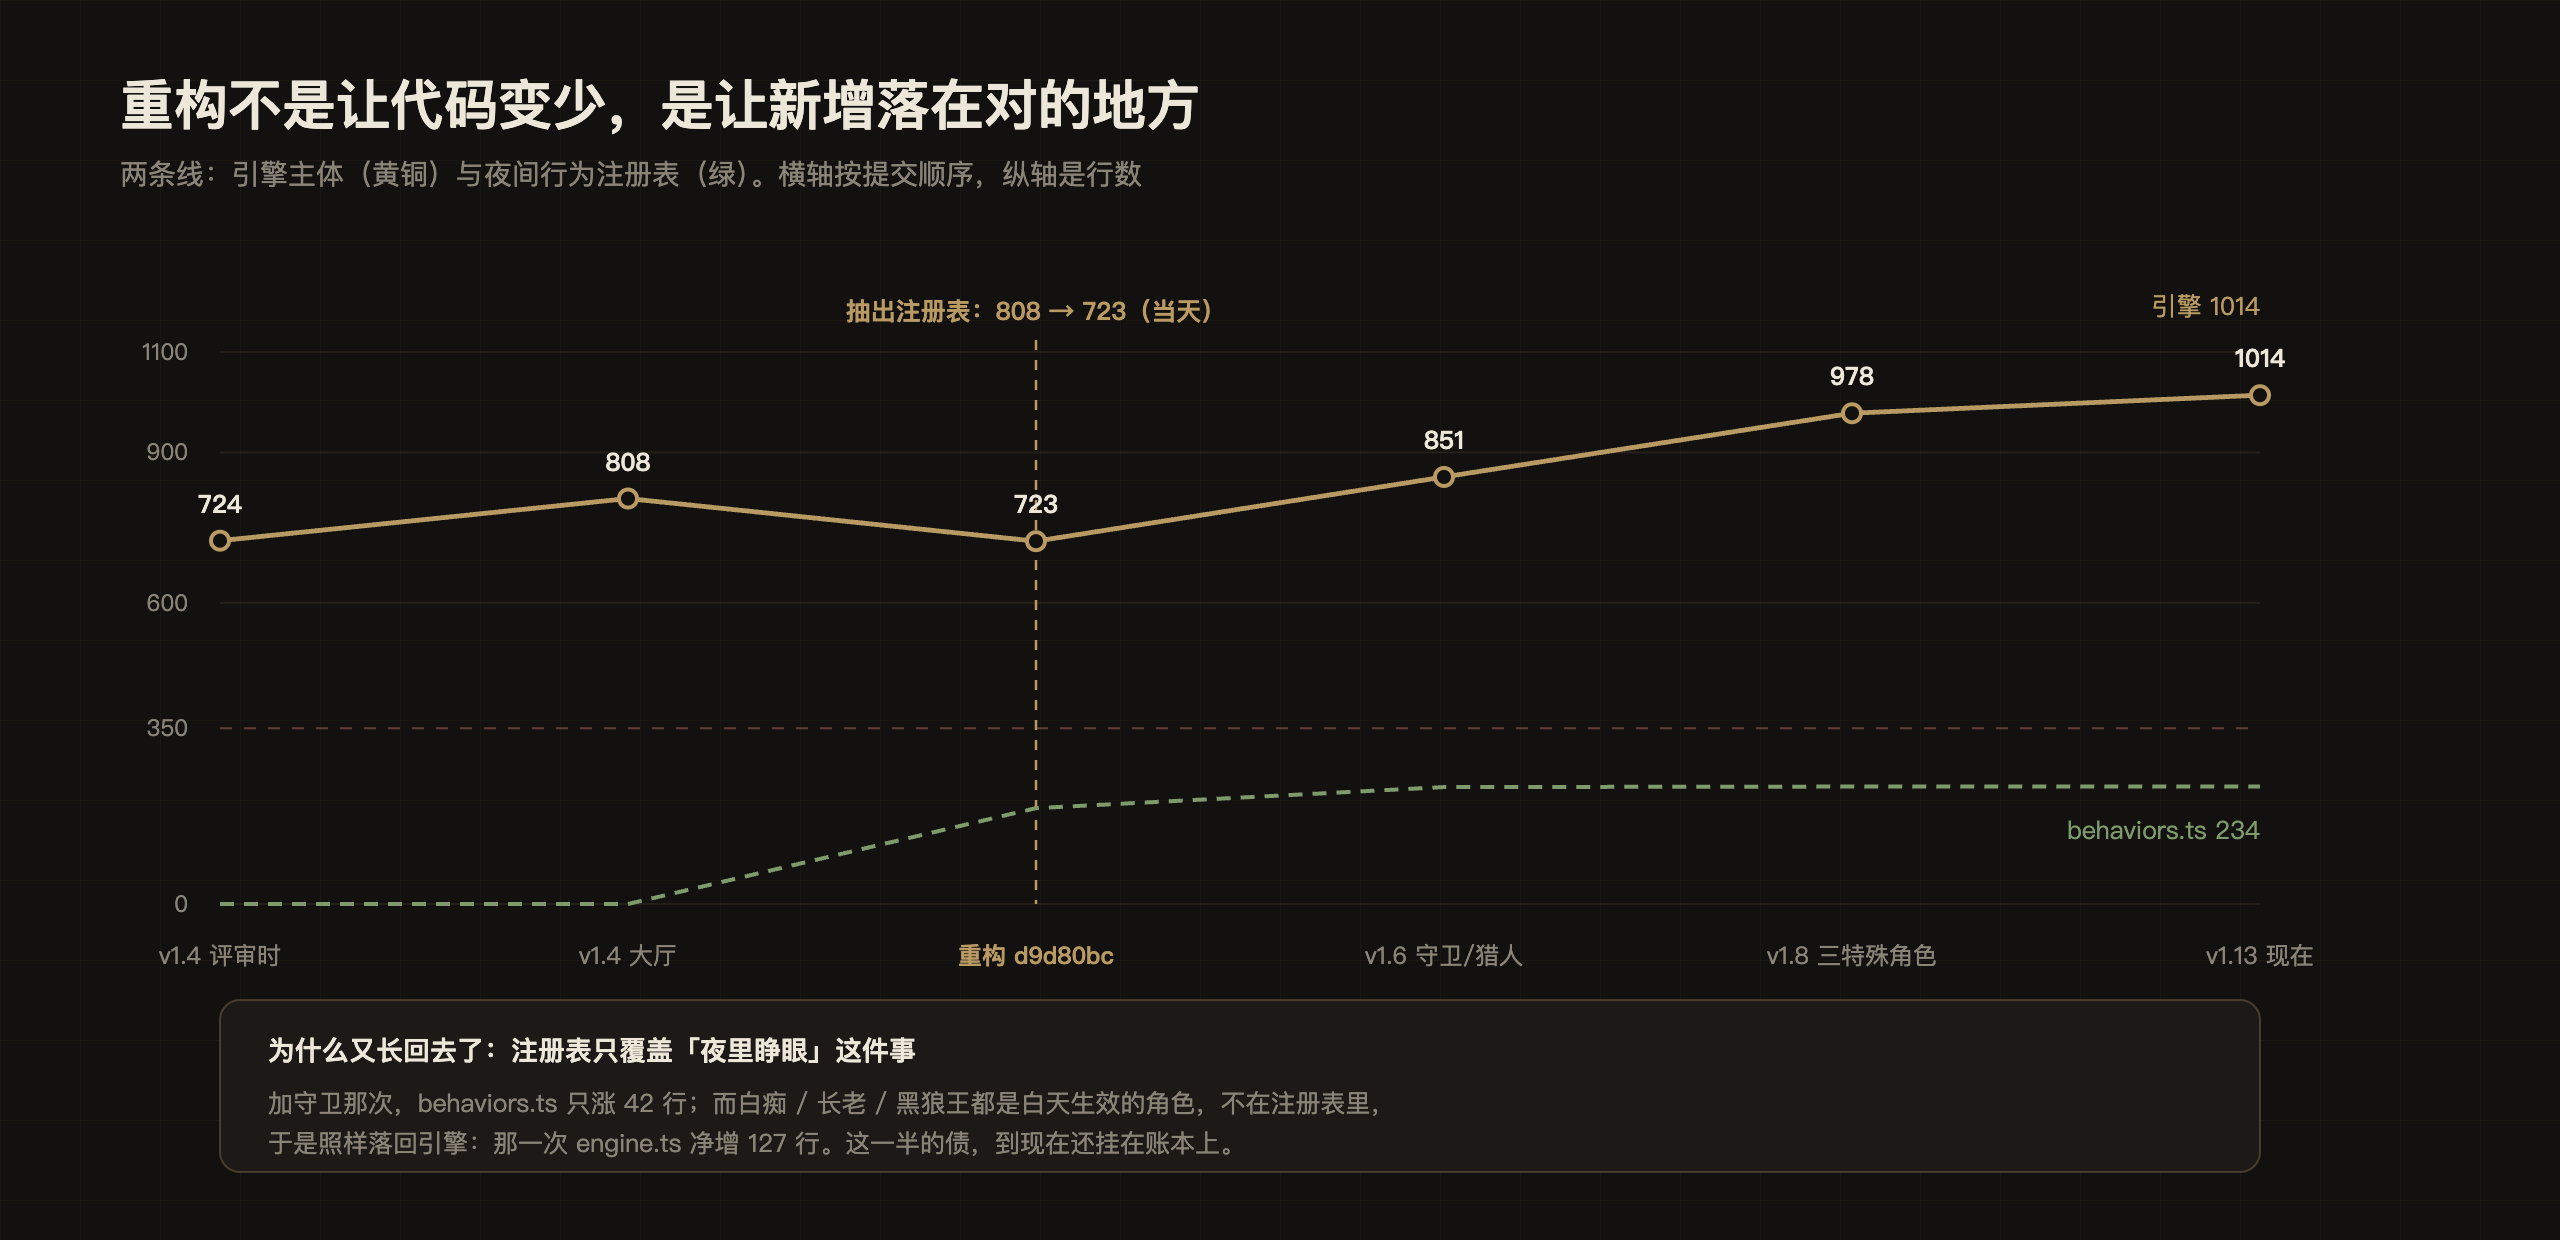
图:引擎主体(黄铜)与夜间行为注册表(绿)。重构当天引擎降了 85 行,之后一路涨到 1014 行。
所以,我们应该定期迭代一部分功能之后就进行技术债务的清偿。(这次为了尽快完成作品提交,所以后来就没有再投入精力重构了)
内容小结
- 技术债要上账本,别靠感觉:724 / 350、15 处
if、5~8 处改动——这三个数一摆出来,“要不要重构”就不是审美问题了。 - 让 AI 评审它自己的产出,比让它继续写更能暴露问题;要求它给文件、行号、次数,不要给形容词。
- 重构提示词的核心是两条禁令:对代码的规范性、封装性和扩展性进行评估。
- 可迁移吗? 任何让 AI 长期维护的项目都需要定期重构优化。尤其是那种“每次加功能都要改核心文件”的代码——那就是在给未来的自己挖坑。
参考资料
- 项目仓库:
werewolf-ai的src/game/behaviors.ts、src/game/engine.ts - 数据来源:
docs/CODE-REVIEW-2026-10-22.md(提交df5f941);代码截图取自8076bbb,行数演进按提交顺序统计 - 重构相关测试:
tests/engine-smoke.test.ts、tests/roles.test.ts - 上一篇:第3篇:
SDD规格驱动开发教程——越加功能,AI 越开始「编」 - 下一篇:第5篇:提示词工程教程——六个 AI 说话一模一样
[评论 0]
评论加载中…