【项目实战】第1篇:AI 编程入门教程——AI 偷偷写了兜底,我还以为它能跑
系列:《用 AI 写出高质量代码:AI 狼人杀开发实录》 本篇对应版本:v1.0 → v1.2.1|时间:2026-10-22 上午
前言
WorkBuddy 办了个「1024 造物挑战」程序员节应用创作大赛:用 WorkBuddy 做一个应用,发布到活动页就算参赛,分网页应用和小程序应用两类。奖励是积分制——一等奖 4000 积分、二等奖 3000、三等奖 2000、参与奖 500,另有周边。
实战结果是:两天里跑出 119 次提交、13 个版本、约 1.2 万行代码,从"一句话需求"变成一个有 5 个会说谎的 AI、能邀请朋友、能分享战绩卡的完整应用。整个过程我记下了九次"翻车",这一篇是第一次,也是最典型的一次。
本篇要解决的问题:AI 给你的第一版代码,为什么"看起来能跑,其实是假的"。
引子:一句话,二十分钟,一个能点的游戏
我对它说的话很短:
目标:
1、做一个狼人杀网页游戏。玩家是 1 个人,其余座位由 AI 补位。AI 的发言、投票、夜间行动都要真的调用大模型,不能是提前写好的台词。
其余五格——背景、流程、要求、资料、输出位置——我当时一个都没填。这一篇后面所有的问题,基本都长在没填的那几格里。
二十分钟后我拿到了一版能玩的东西:首页有月亮和狼,配置页能选人数,进对局能看见 AI 按顺序发言、能投票、能走到结算。
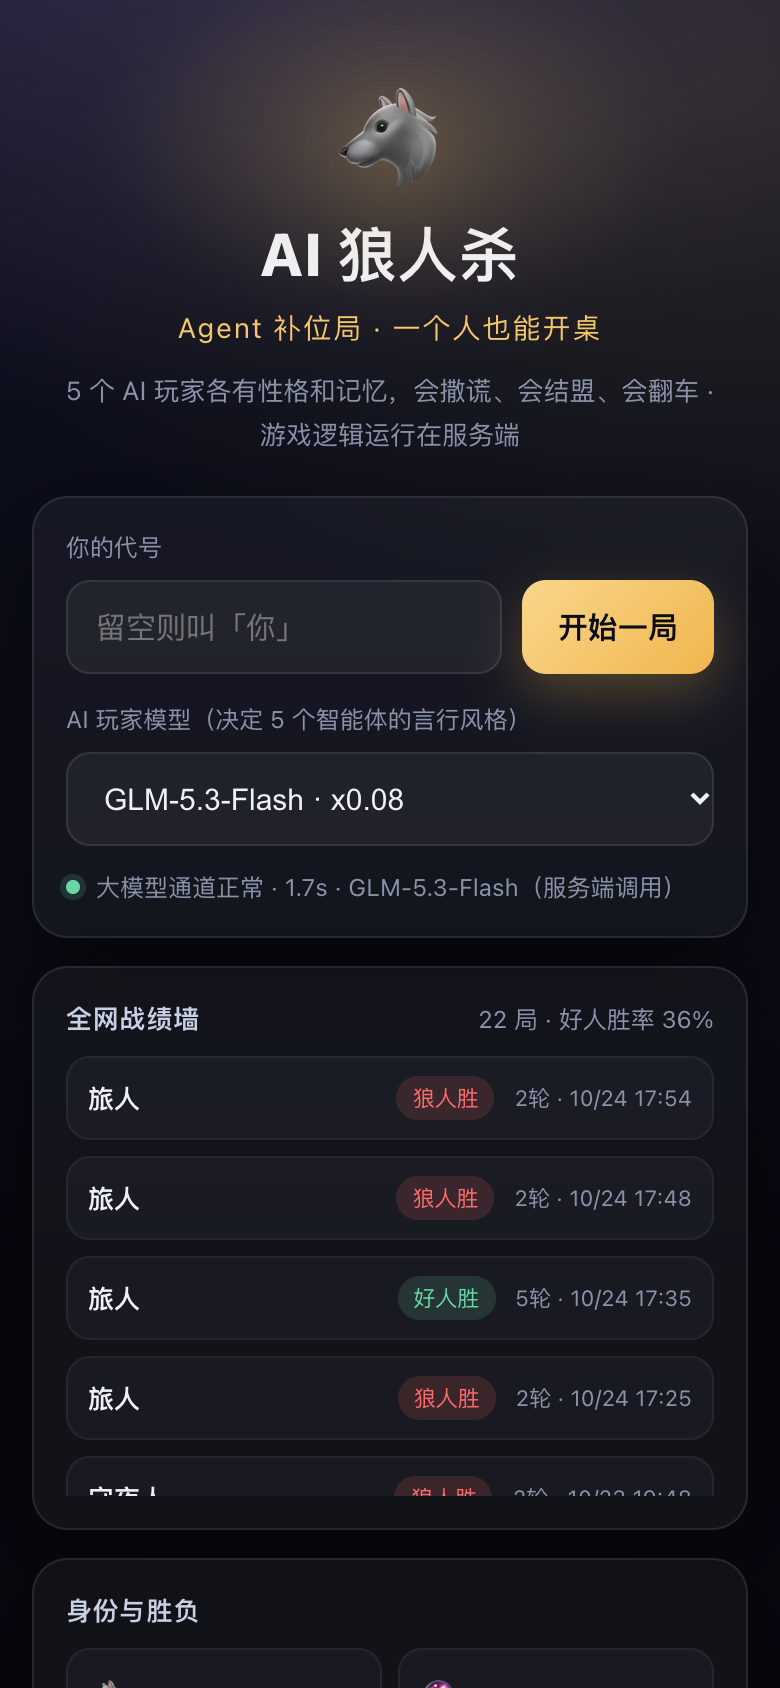
图:v1.2.1 的首页(从当时的提交里跑出来的)。狼头、代号输入、模型选择器、下面一行「大模型通道正常 · 1.6s」——看起来已经像个产品了。
问题:玩了九局,我才发现台词是"录好的"
那天下午我玩了九局。到第九局,我意识到一件怪事:不管谁是狼、不管什么局势,AI 说话都是一个味道——都是"我觉得 X 比较可疑,我先听听别人怎么说",都是两句,都从"发言顺序"切入。
我以为是提示词太笼统,打开代码准备加人格,然后看见了这一段:
// 当时的写法(大意,原代码已删除)
let speech = await callLLM(prompt);
if (!speech) {
  speech = fallbackSpeech(player, state); // 几十条本地话术
  degraded = true;                        // 界面上看不见
}
fallbackSpeech 是一个本地话术库。调用失败、超时、返回格式不对,任何一条发生,它就从库里挑一句顶上,再打一个 degraded 标记——而这个标记,界面上根本不显示。
当时的对局页是这样的(也是从 v1.2.1 里跑出来的):
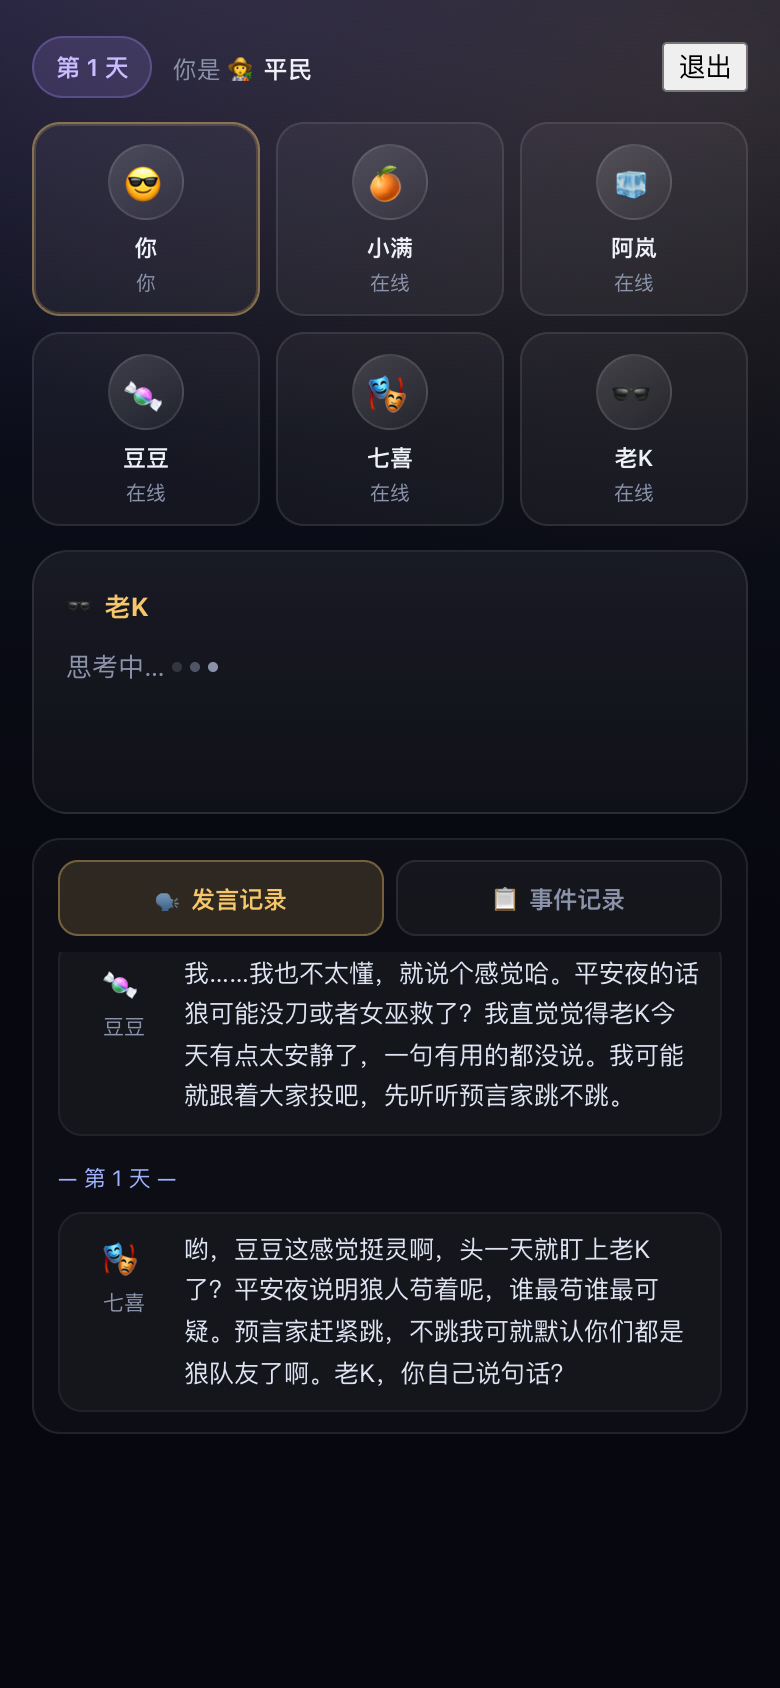
图:第 1 天的发言记录。豆豆和七喜两个人,起手都是「平安夜」,都是先抛感觉再跟票——风格差异只体现在语气词上。
所以那九局里,有多少句是真的模型生成的,我自己也不知道。
这不是一个 bug,这是一个"贴心的谎言"。 它不报错、不崩、看起来一切正常。
说句实话:那段代码只活了三个小时。首版提交(
30b7288)时它已经被删掉了,所以没有留下历史截图——我能给的证据只有上面这段代码,和当天"九局台词雷同"的观察。这一篇后面所有截图,都是修好之后的样子。
问题原因:AI 的默认动作是"别让它崩"
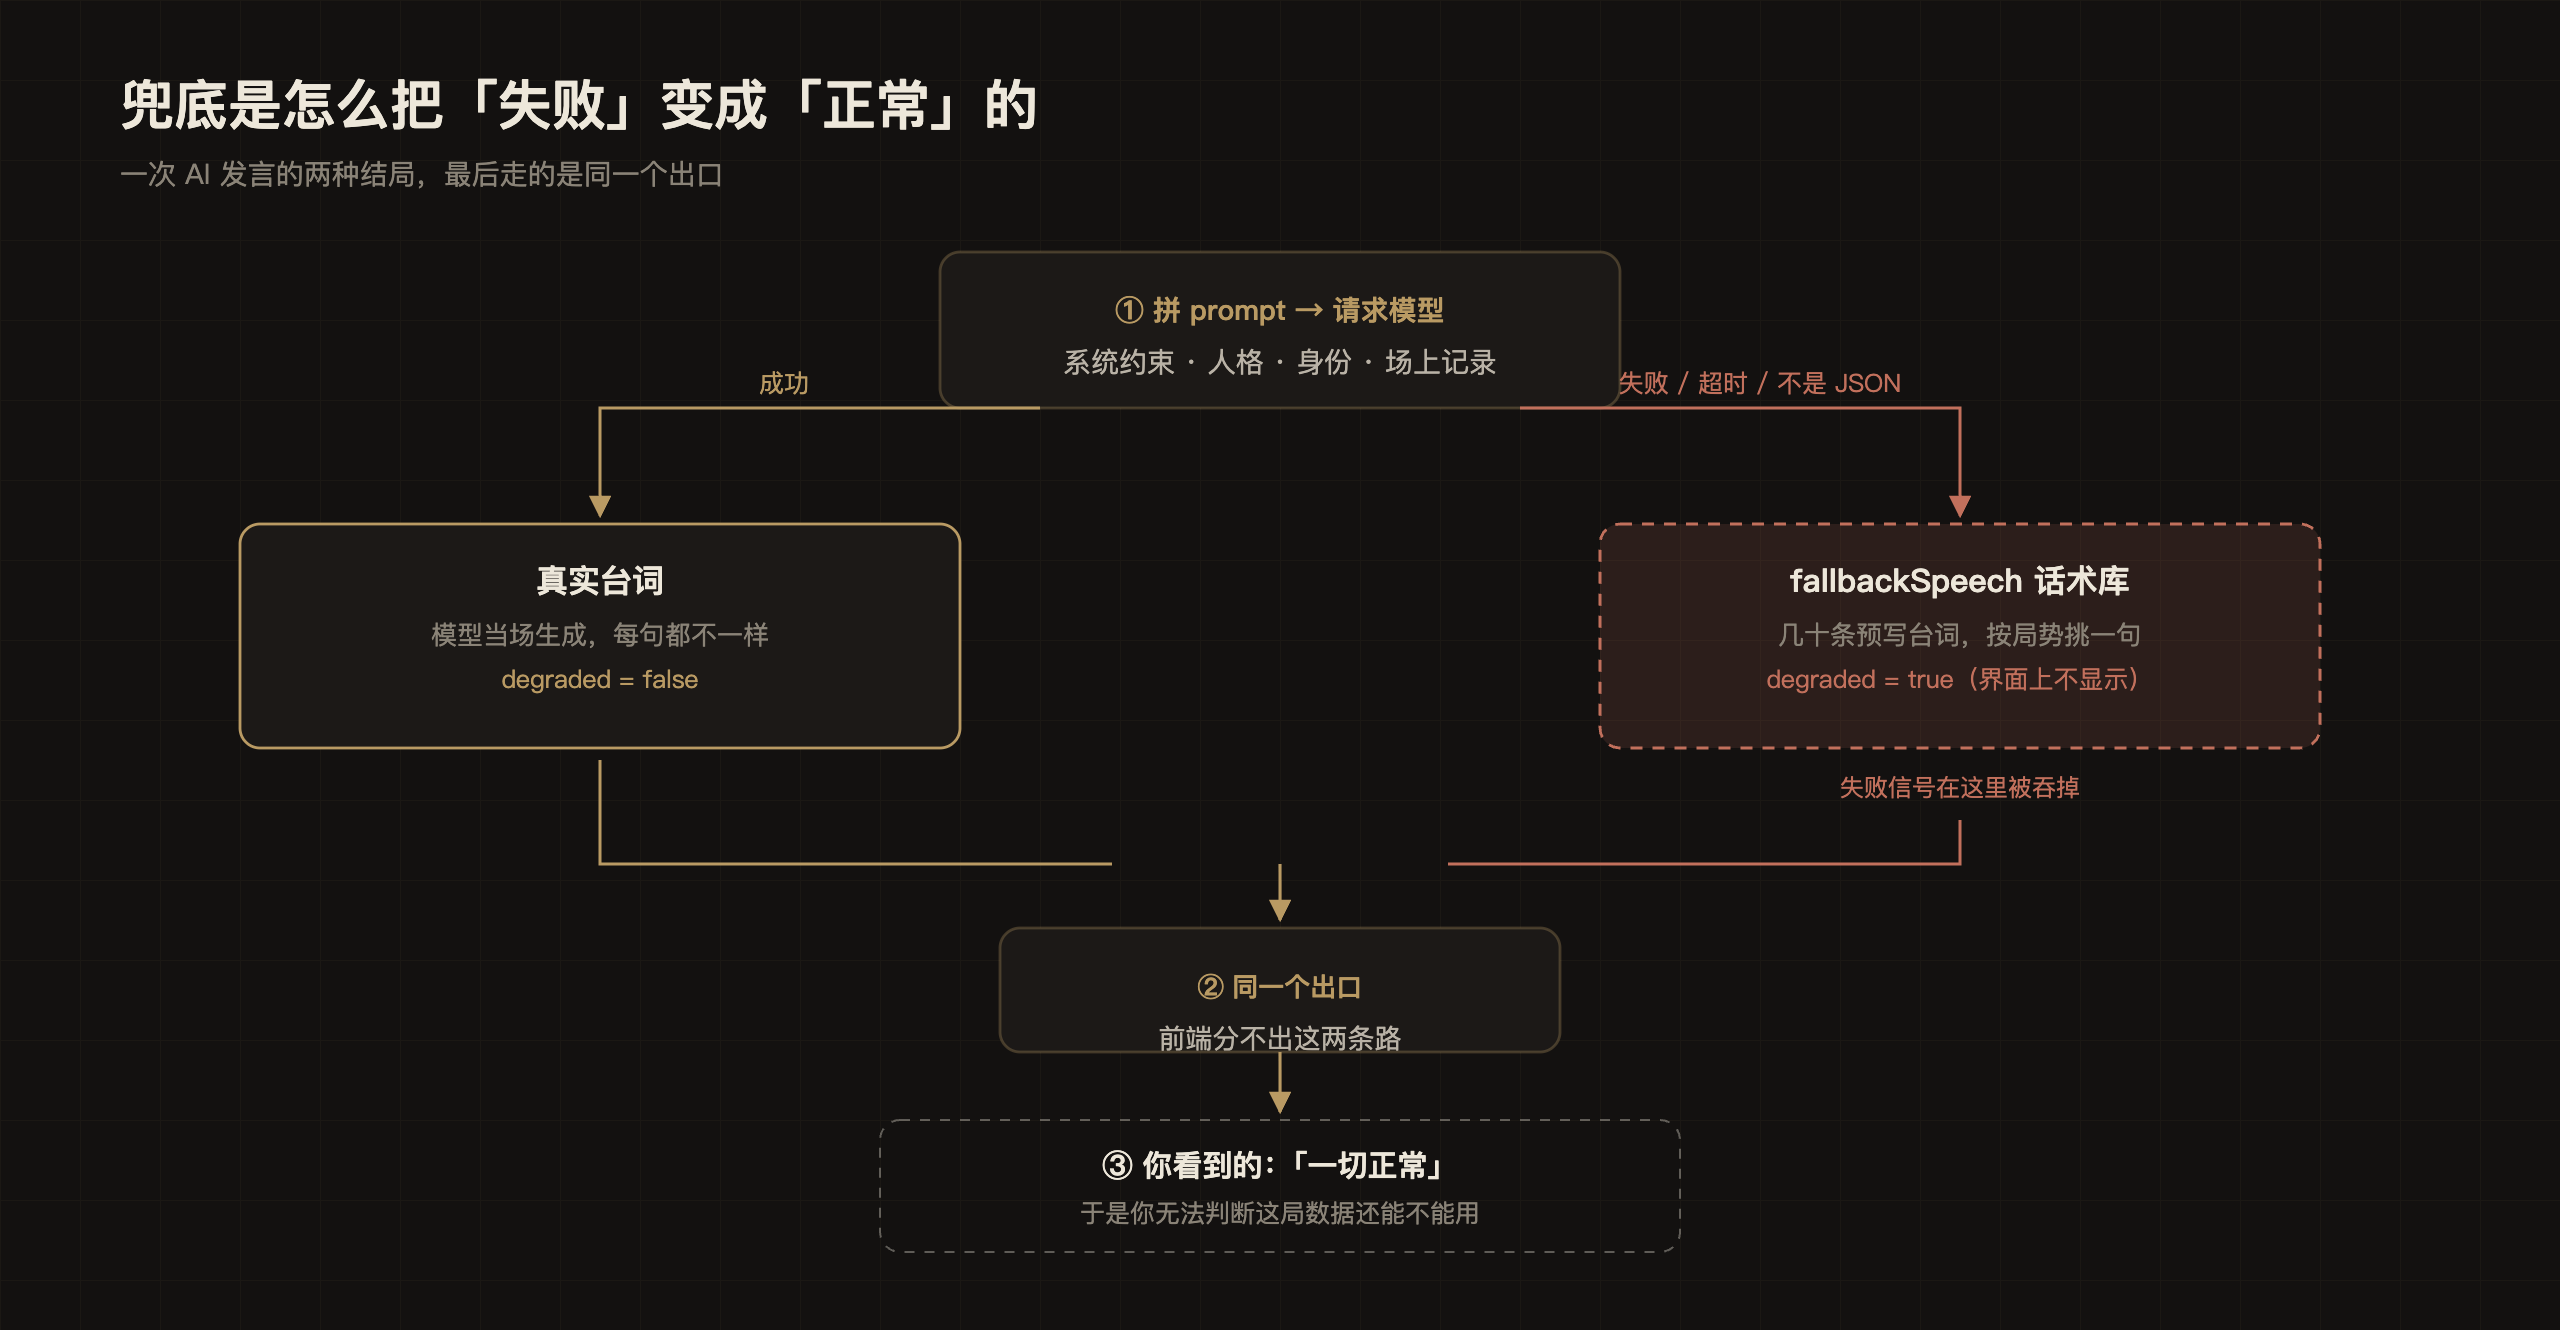
图:一次 AI 发言的两种结局。「成功」走左边,拿到真实台词;「失败」走右边,从话术库里挑一句顶上,再打一个界面上不显示的标记。两条路最后汇进同一个出口——所以你看到的永远是"一切正常"。
第一层,模型的偏好。 模型写代码时会根据历史学习的代码,容易产生过度设计的问题,即:"别报错":加 try/catch、加默认值、加 ?? '默认文案'。
第二层,实际的场景。 我们实际开发的场景,需要的是"每句话都真的由模型生成"。如果出现模型调用失败,应该有友好的提示让我们能够感知到——图里那条红色虚线,应该给出一些友好的提示。
所以,异常失败是常态,不是意外。 所以真正的问题不是"怎么让它不失败",而是"失败了怎么办"。三种处理,对应三种质量:
| 处理方式 | 玩家看到 | 你失去什么 |
|---|---|---|
| 兜底话术(当时的做法) | 一切正常 | 分不清真假,数据全废 |
| 静默重试 3 次再兜底 | 一切正常,稍慢 | 同上,还多了延迟 |
| 失败就中止并说清原因 | 一句明确的错误 | 这一局玩不了,但你知道发生了什么 |
解决方案:拆掉退路,让失败亮灯
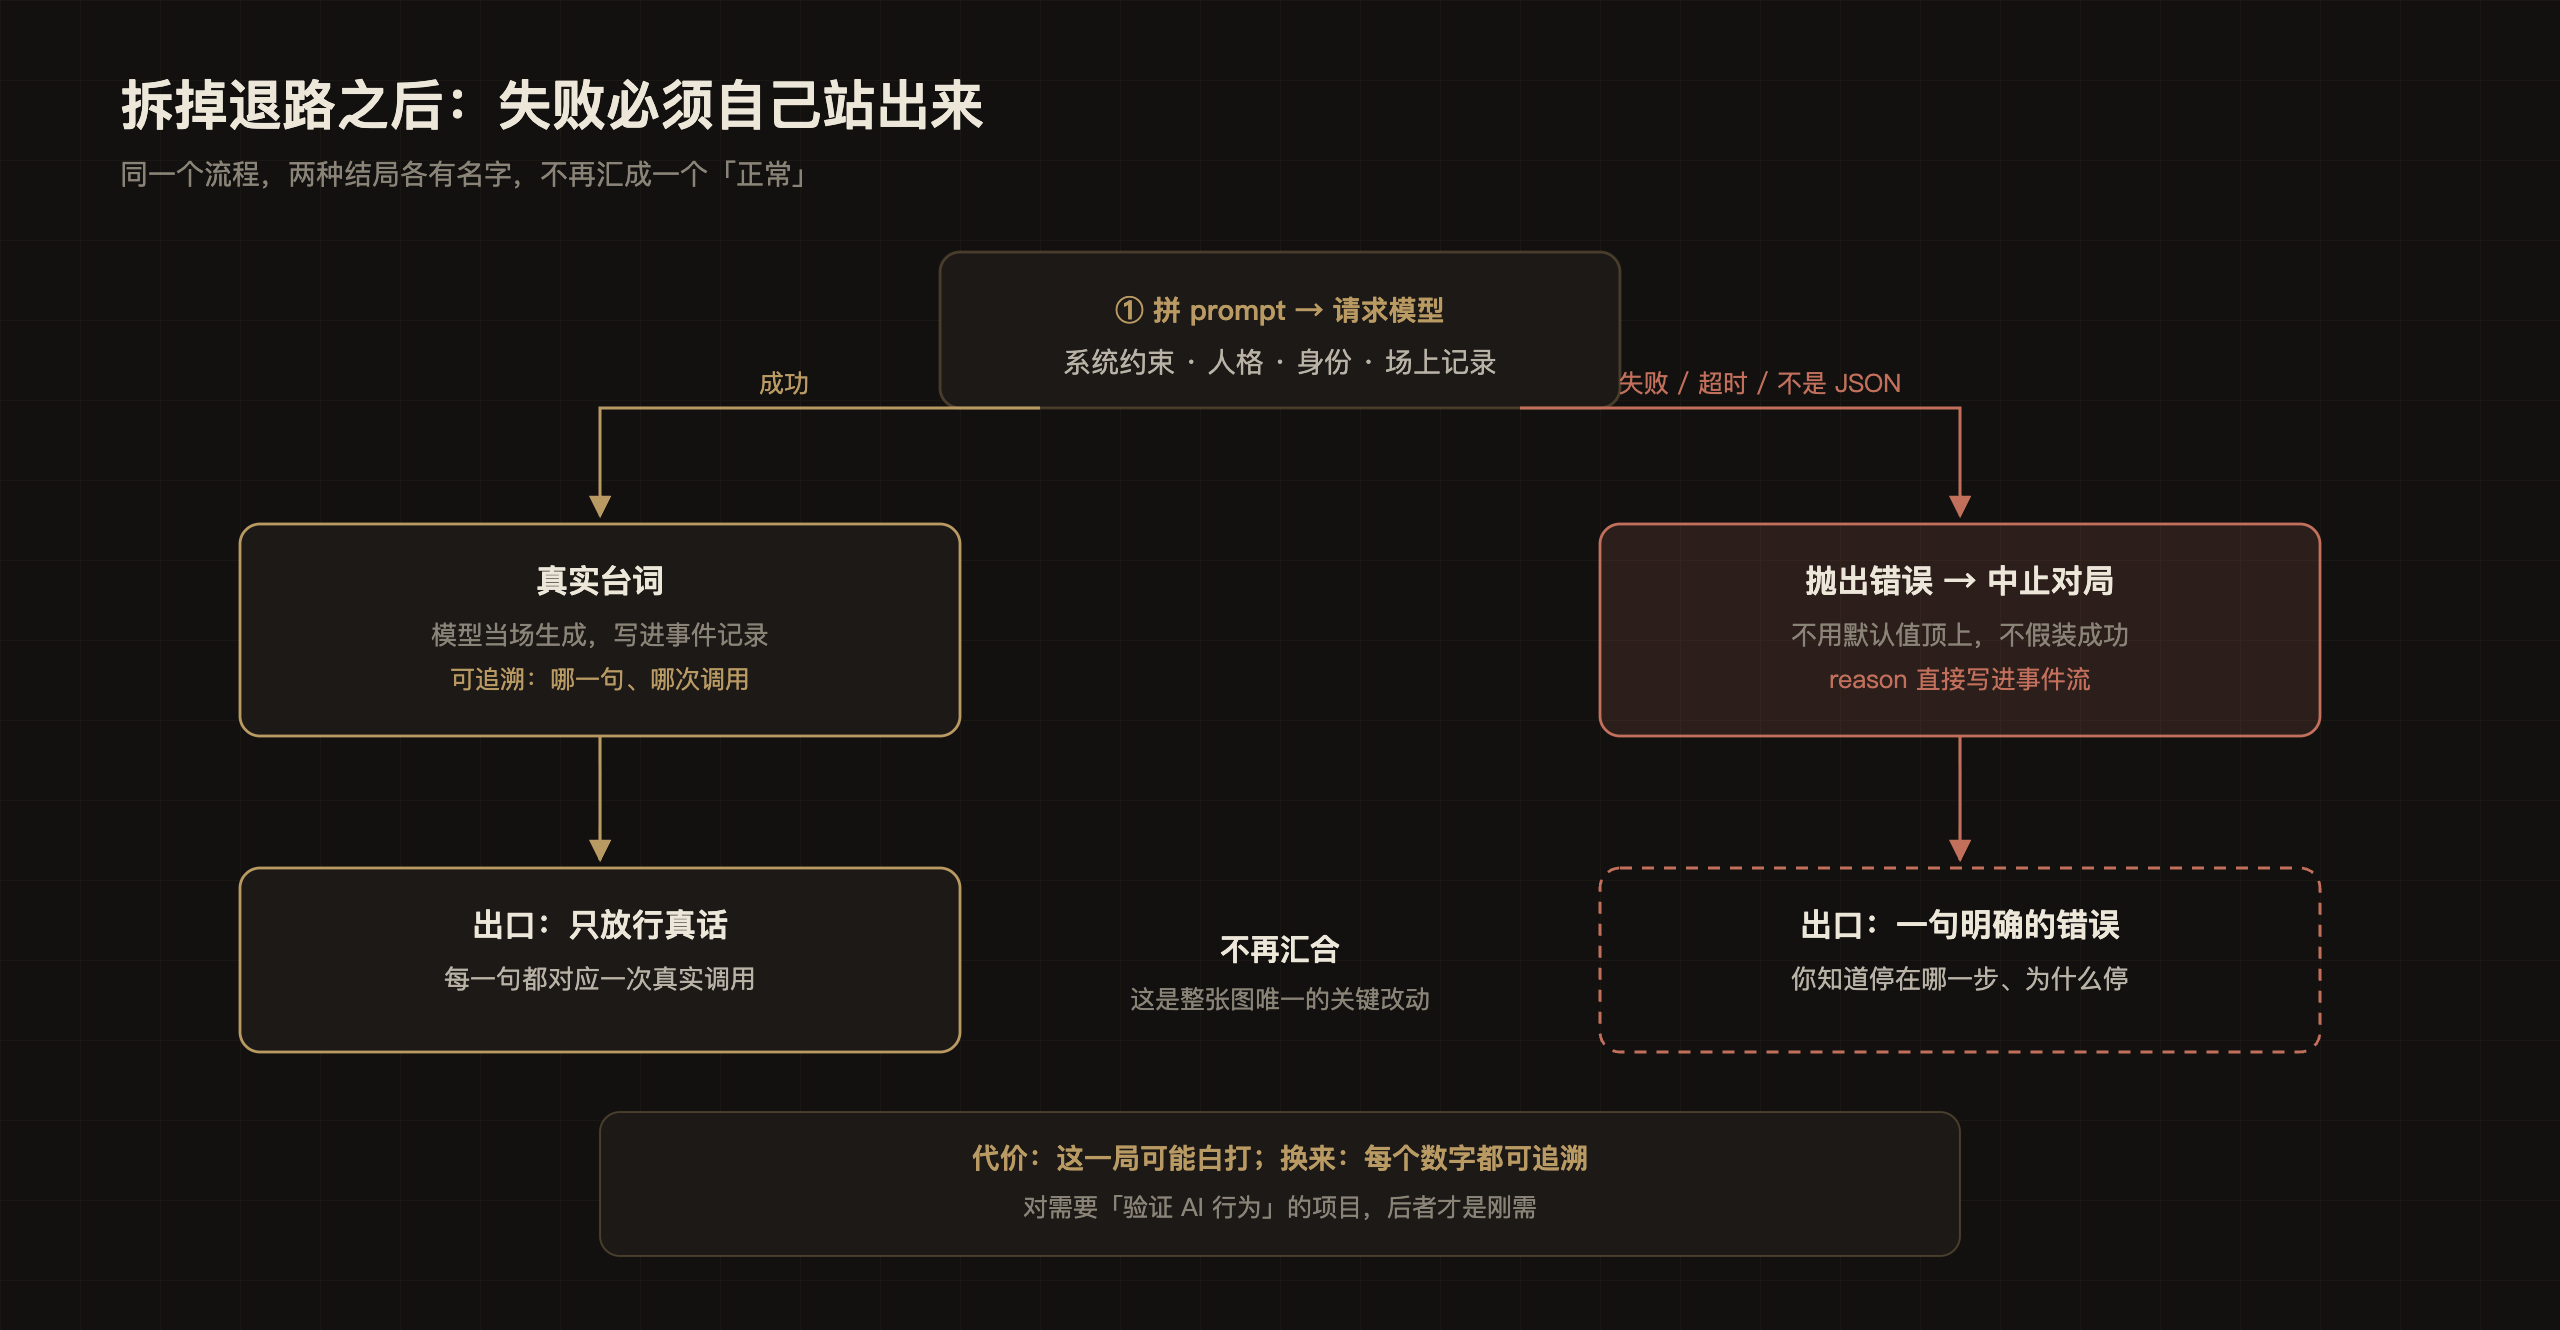
图:同一个流程改完的样子。左路照旧放行真话;右路不再找替补,而是直接抛错、中止对局,把 reason 写进事件流。两条路不再汇合——你永远知道自己面对的是哪一种。
这一步真正的变化不是"更好用",而是"可诊断"。 之前是一个看起来正常的黑盒,之后每次异常都有名字。
代价是一局可能因为网络抖动直接中止——真实遇到过的失败至少三种:输出不是合法 JSON(最常见)、调用超时、返回 5xx。第一次遇到时我本能地"加重试",后来发现重试只降低概率:模型有时就是会输出一段解释文字包着 JSON,真正的解法是容错解析(先直接 parse,失败再从文本里抠出第一个 {...})。
效果:一眼能看见通道状态
改完最直接的一处变化,是首页多了一行「通道状态」:
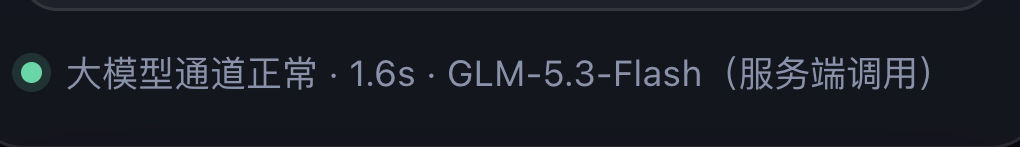
图:v1.2.1 首页的通道自检。它每次加载都真的调一次模型,把结果、耗时、模型名报出来——这一行在,我就不会再一次玩完九局才发现自己在玩假局。
内容小结
- AI 写代码的默认偏好是"让程序不崩",所以在需要真实性的场景里,它会主动把失败藏起来。
- 让失败可见比让失败消失,更重要的是抛错 + 中止 + 可诊断 + 友好提示,质量高一个量级。
- 有什么可启示的方法论? 任何"AI 生成内容 → 展示给用户"的链路(审核、客服、报告、补全)都应该考虑可观测性,不要让模型直接兜底,而是给出不同错误的处理以及提示,并且做好日志+可观测性处理。
参考资料
- 项目仓库:
werewolf-ai(src/ai/ai-player.ts的提示词与错误处理) - 线上体验:https://werewolf-ai-01048.app.workbuddy.host/?sharecode=2IBHTRFFFL
- 下一篇:第2篇:JavaScript 与 Node.js 教程——换个窗口就能作弊
[评论 0]
评论加载中…